
連載
すべての連載 →記事
AIサービスの有料版と無料版、仕事でどう使い分ける?失敗しないための判断基準
AIを仕事に取り入れたいけれど、いきなり有料プランに入るべきか迷っている方へ。無料版でまず「体験」することの重要性と、有料版に移行する際の主なチェックポイントを解説します。
CPUのスレッド数を減らしてもAIの生成速度が変わらない理由について
AIモデルを自分のPCで動かす際、CPUのスレッド数を調整することで速度が変わるのか、実測データをもとに解説します。
ローカルAIのモデル名にある「Q4」「Q8」の意味とは?量子化の仕組みを分かりやすく解説
AIモデルの名称によく見られる「Q4」や「Q8」という表記。これらはAIを軽量化するための「量子化」という技術に関係しています。初心者の方向けに、それぞれの違いや選び方の基準を解説します。
【実測データ公開】GPUなしのPCでもローカルAIを快適に動かすためのモデル選び
「自分のPCにはグラフィックボード(GPU)が入っていないから、ローカルAIは諦めるしかない」と考えていませんか?実は、モデルのサイズを適切に選ぶことで、CPUのみの環境でも十分に実用的な速度でAIを動かすことが可能です。本記事では、実測データに基づいた「GPUなしで動かすための条件」を詳しく解説します。
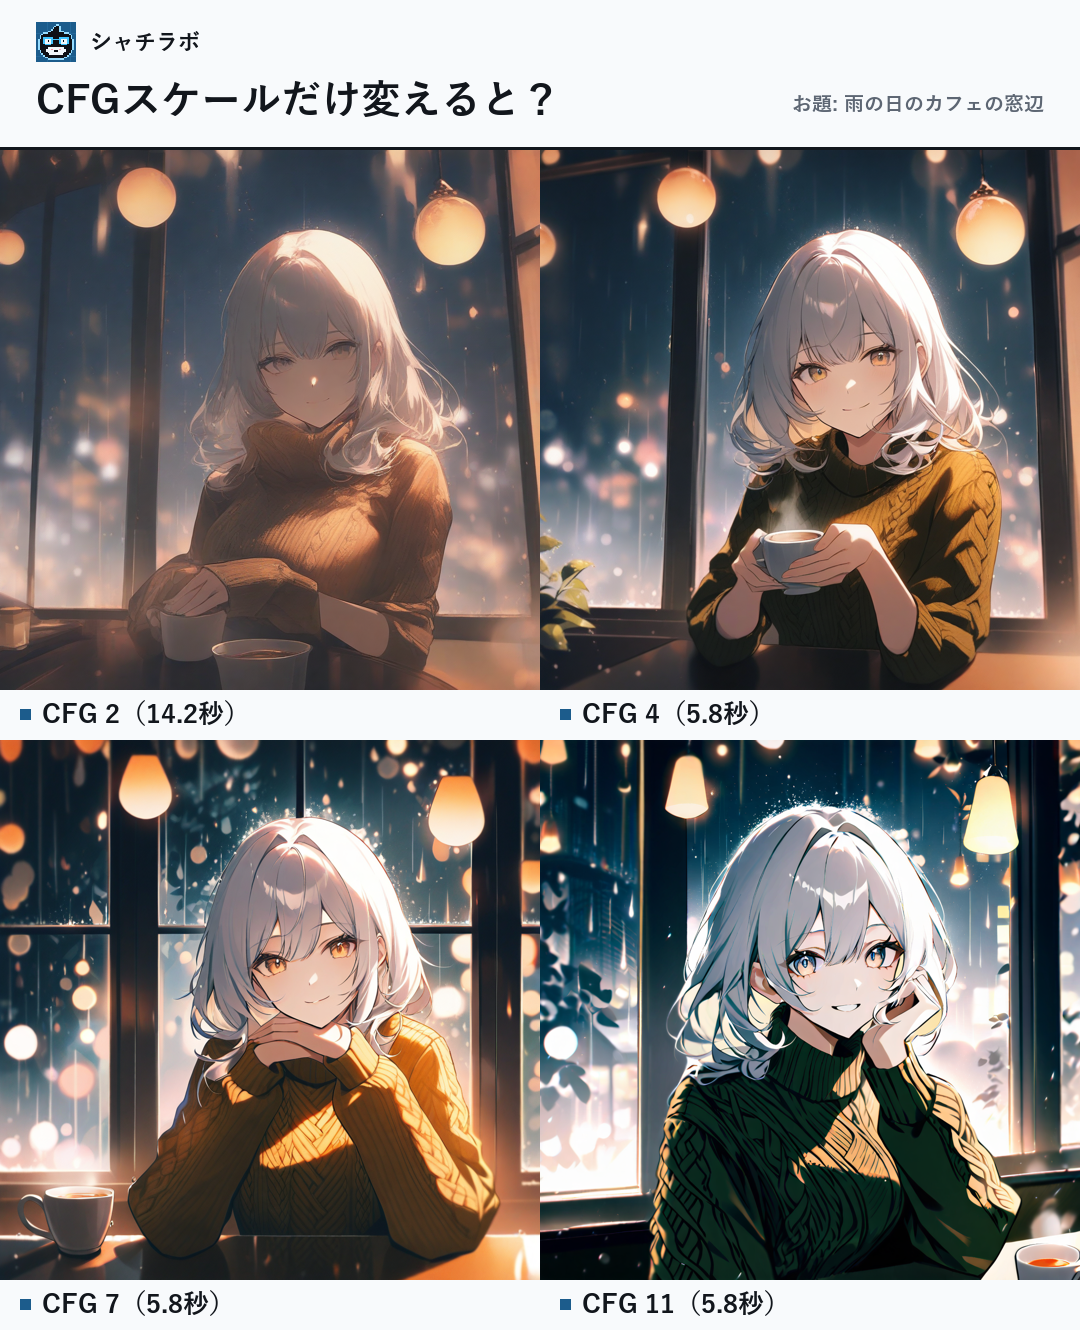
CFGスケールひとつで絵はどう変わる?数値による指示の反映度を徹底解説
画像生成AIにおいて非常に重要なパラメータである「CFGスケール」に焦点を当て、数値の変化が生成される画像の雰囲気にどのような影響を与えるのかを解説します。
Claude Codeで動画編集を自動化?8時間の素材を30分で処理した検証結果
AIツール「Claude Code」を用いて、膨大な動画素材をいかに効率よく編集できるかを検証した結果を詳しく解説します。
メモリ8GBのPCでもローカルAIは動く?実測データから判明した「ちょうどいい」モデルの選び方
「自分のPCのスペックでは動かないかも」と諦めていた方へ。メモリ8GBの環境でも、モデルの選び方次第でローカルAIを快適に活用できることを実測データをもとに解説します。
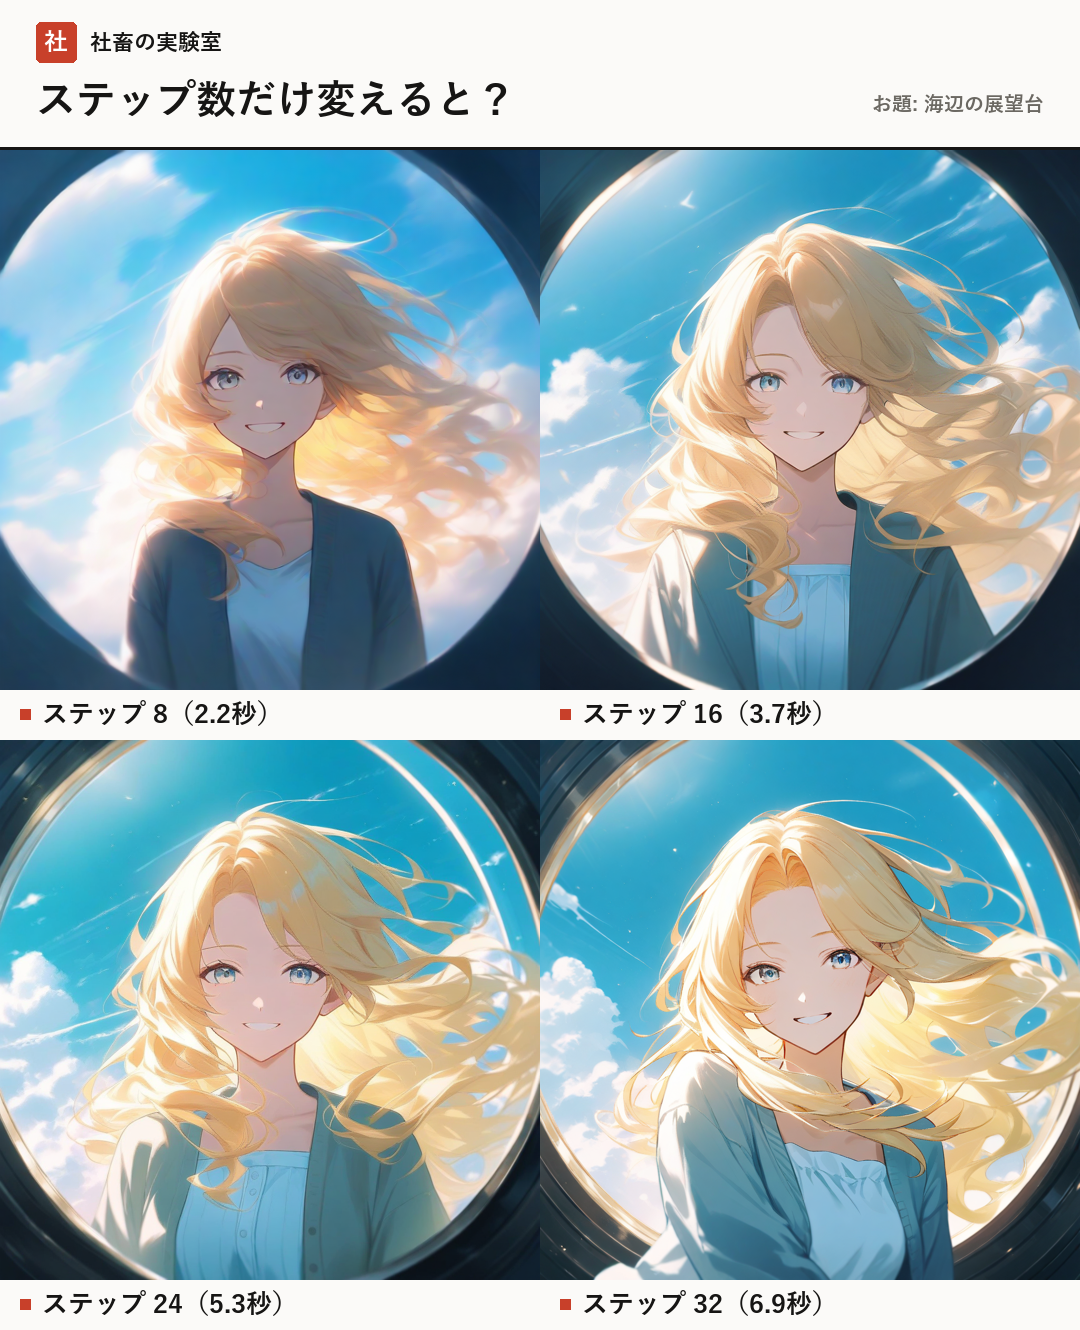
画像生成AIにおける「ステップ数」の影響を検証:描き込みの密度と生成時間の関係
画像生成AIを利用する際に重要となる「ステップ数」という項目。この数値を変更することで、生成される画像の仕上がりや、作成にかかる時間にどのような変化が生じるのか。実際に「novaAnimeXL」というモデルを用いて比較実験を行った結果を詳しく解説します。
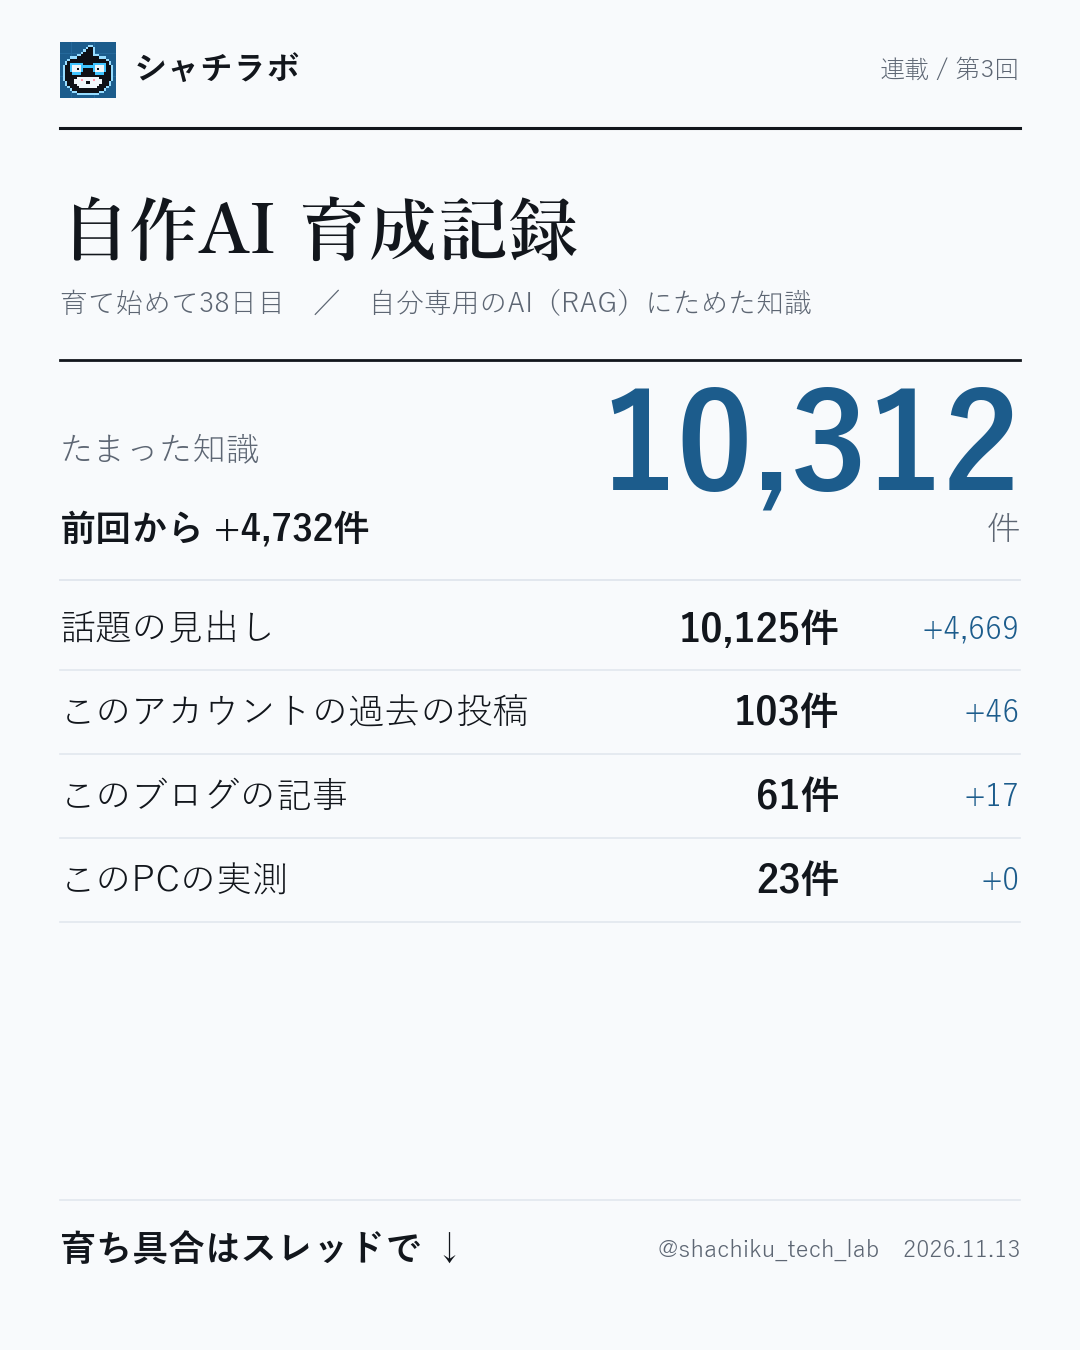
【自作AI育成日記 第3回】わずか38日で知識ベースが1万件を突破した過程と仕組み
自分専用のAIを育成する過程で、どのように知識を集め、どのように活用しているのかを詳しく解説します。
AIにメールの下書きを任せる際に「手直し」を減らすための5つのコツ
AIにメールの下書きを依頼する際、やりがちな「丁寧すぎて長すぎる」「意図と違う」といった問題を解決するための具体的な指示の出し方と、運用上の注意点を詳しく解説します。
【画像生成AI】サンプラー選びで速度は変わる?実験でわかった「使い分け」のポイント
画像生成AIを操作する際、設定項目にある「サンプラー」をどれにするか迷うことはありませんか?今回は、サンプラーの変更が生成時間に与える影響について、実際の実験結果をもとに解説します。
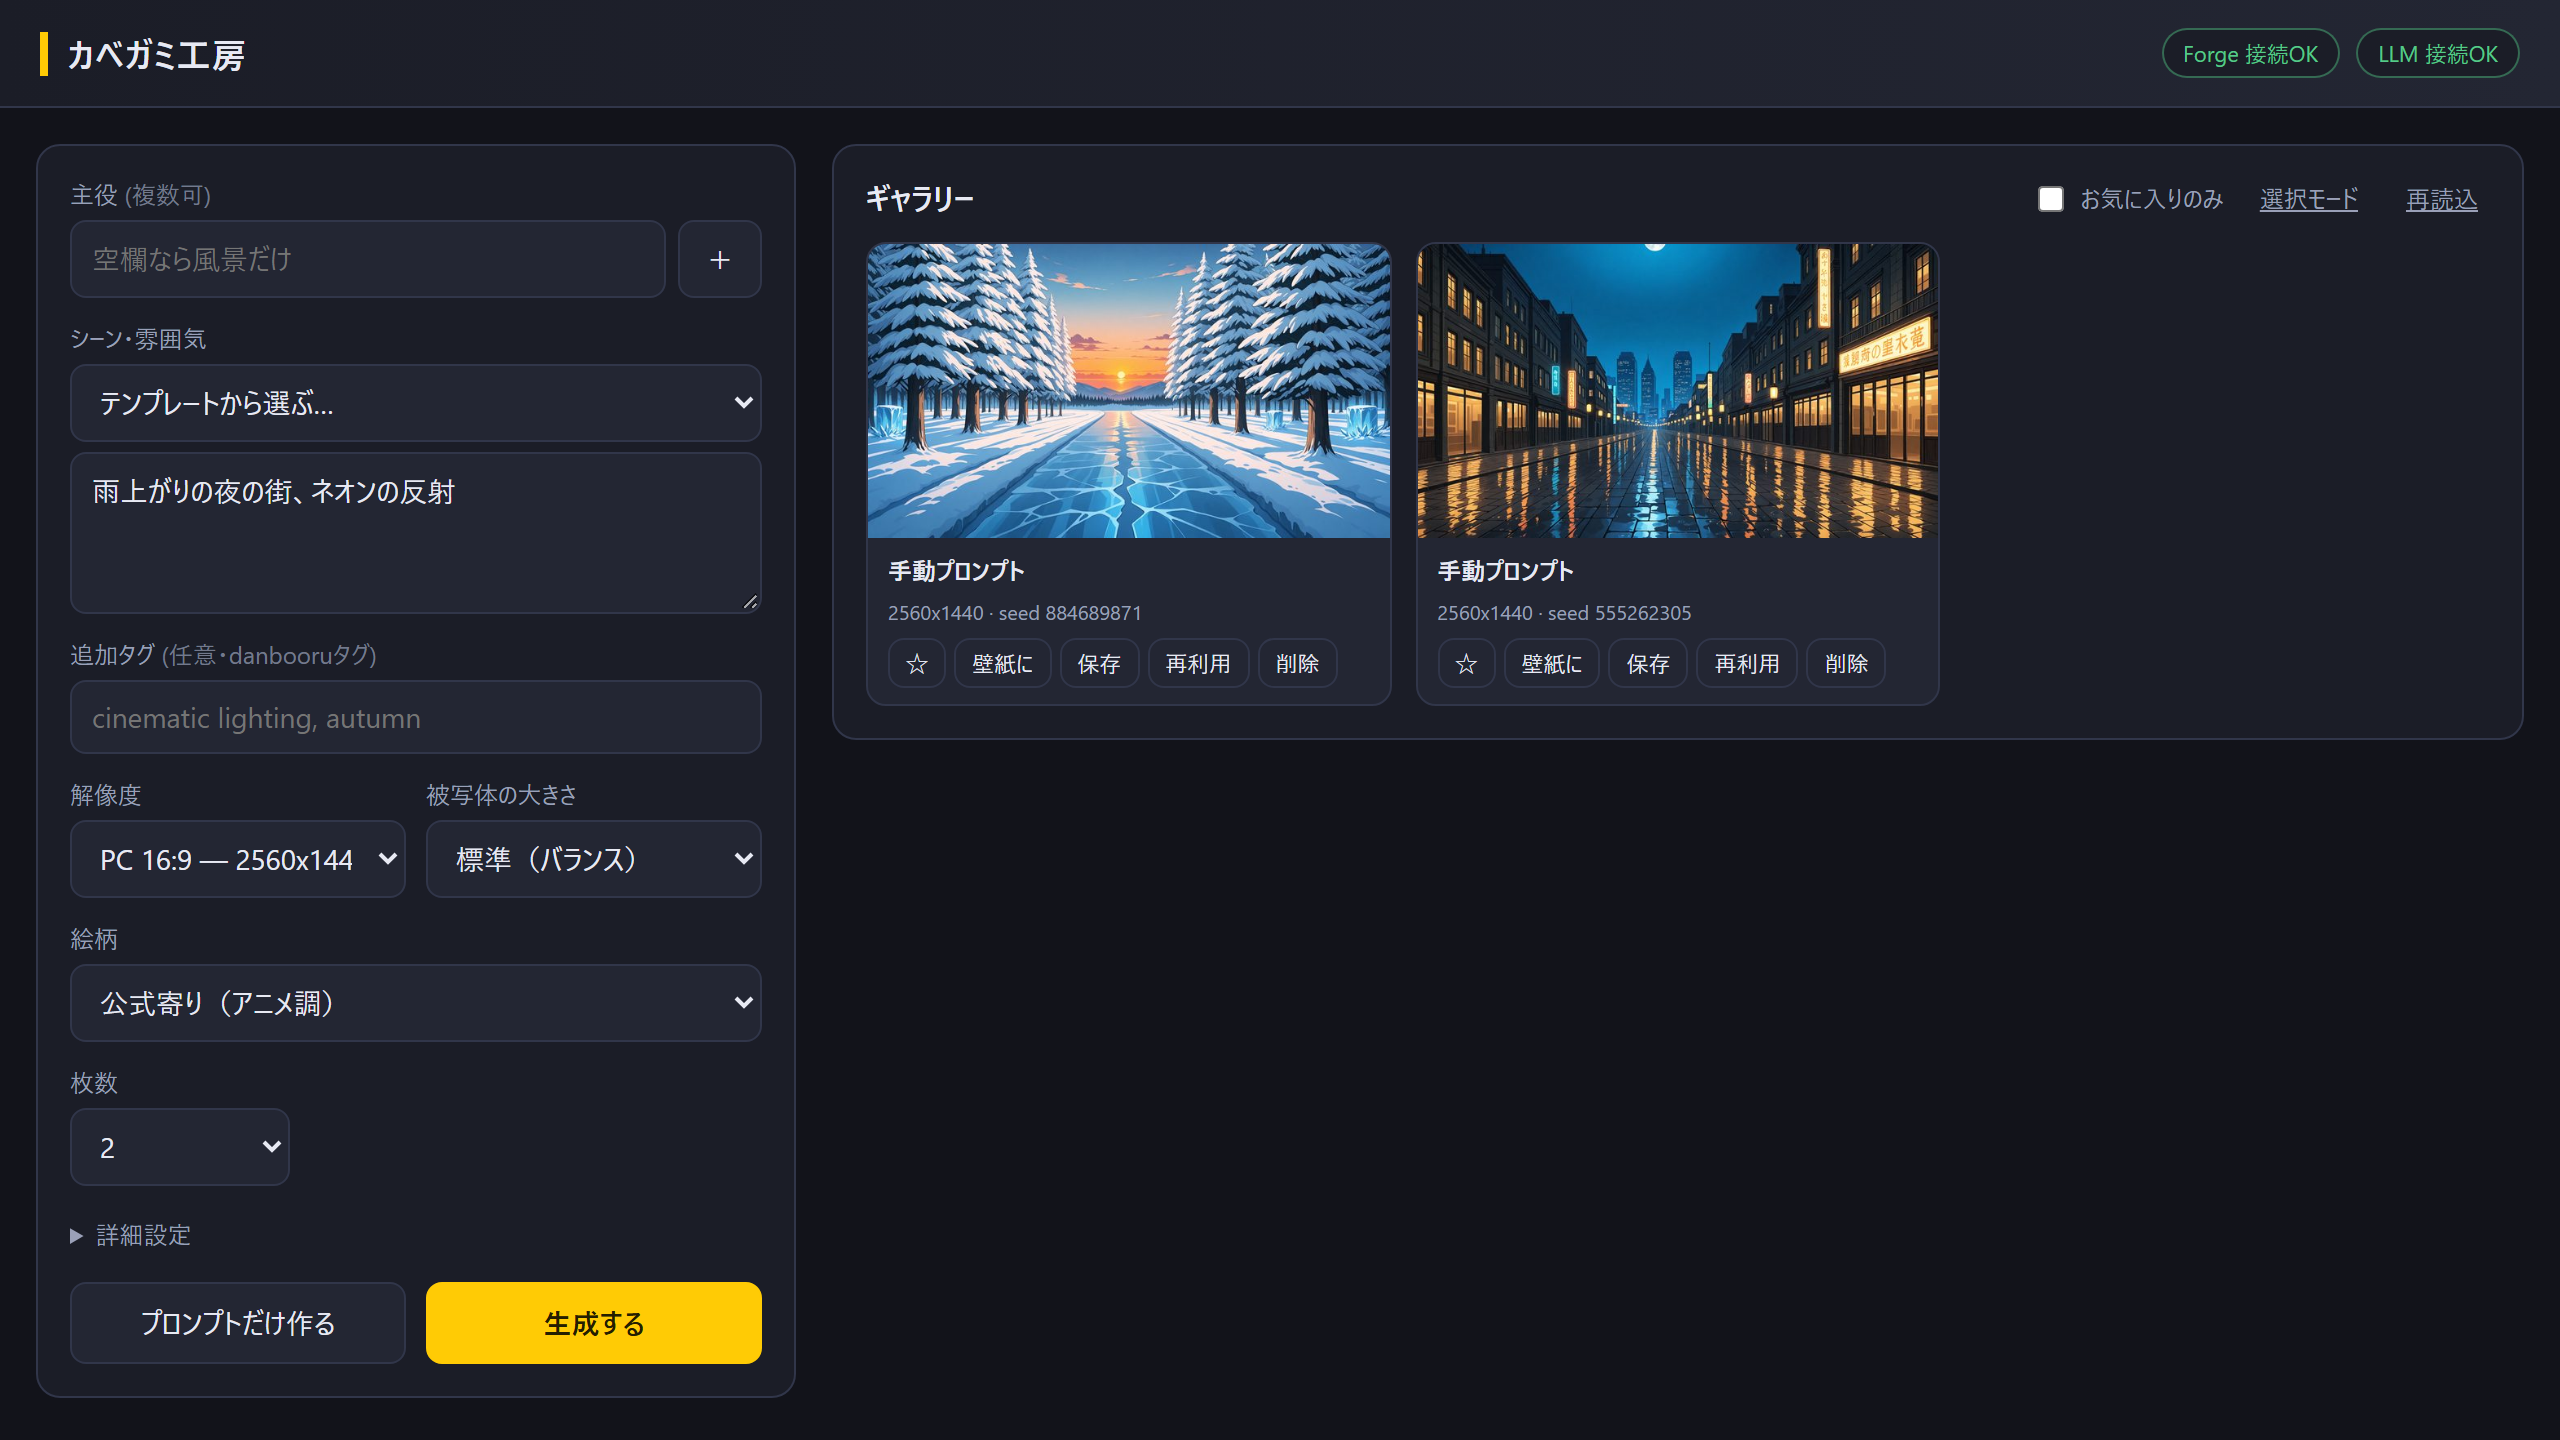
画像が増えても重くならない!ギャラリー表示を劇的に高速化する最適化の技術
「画像が増えるほど動作が重くなる」という、Web制作やアプリ開発でよくある課題を、実際に「カベガミ工房」の最適化を通じて解決した事例を解説します。ブラウザのメモリ管理やデータ処理の効率化について、初心者の方にも分かりやすく紐解きます。
AIモデルの名称「30b-a3b」に隠された仕組みとメリットを解説
AIモデルの名称に含まれる数字が何を意味するのか、初心者の方にも分かりやすく解説します。
AIへの指示を劇的に変える「4つの要素」と改善のコツ
AIへの指示(プロンプト)の精度を上げるための基本的なフレームワークと、効率的なやり取りの方法について詳しく解説します。
AIの回答を「決まった形」で受け取る方法:JSONスキーマの活用
ローカルAIを活用する際に、AIの回答をプログラムで扱いやすい形式に固定するための手法について解説します。
顔の崩れを解決する鍵は「解像度」ではなく「被写体の大きさ」にあり
画像生成AIで「顔だけが崩れてしまう」という悩みに対し、カベガミ工房の実験を通じて判明した「面積の重要性」と、それを解決するための具体的な設計思想を解説します。
メモリ8GBのPCでもローカルAIは動く?実測データから判明した「ちょうどいい」モデルの選び方
「自分のPCのスペックでは、AIを動かすのは無理だろう」と諦めていませんか?実は、メモリが8GBであっても、モデル(AIの脳にあたるデータ)のサイズを適切に選べば、驚くほどスムーズに動かすことが可能です。今回は、実際にメモリ8GBの環境で複数のモデルを動かした実測データをもとに、初心者の方でも安心して試せる「ちょうどいいサイズ」を解説します。
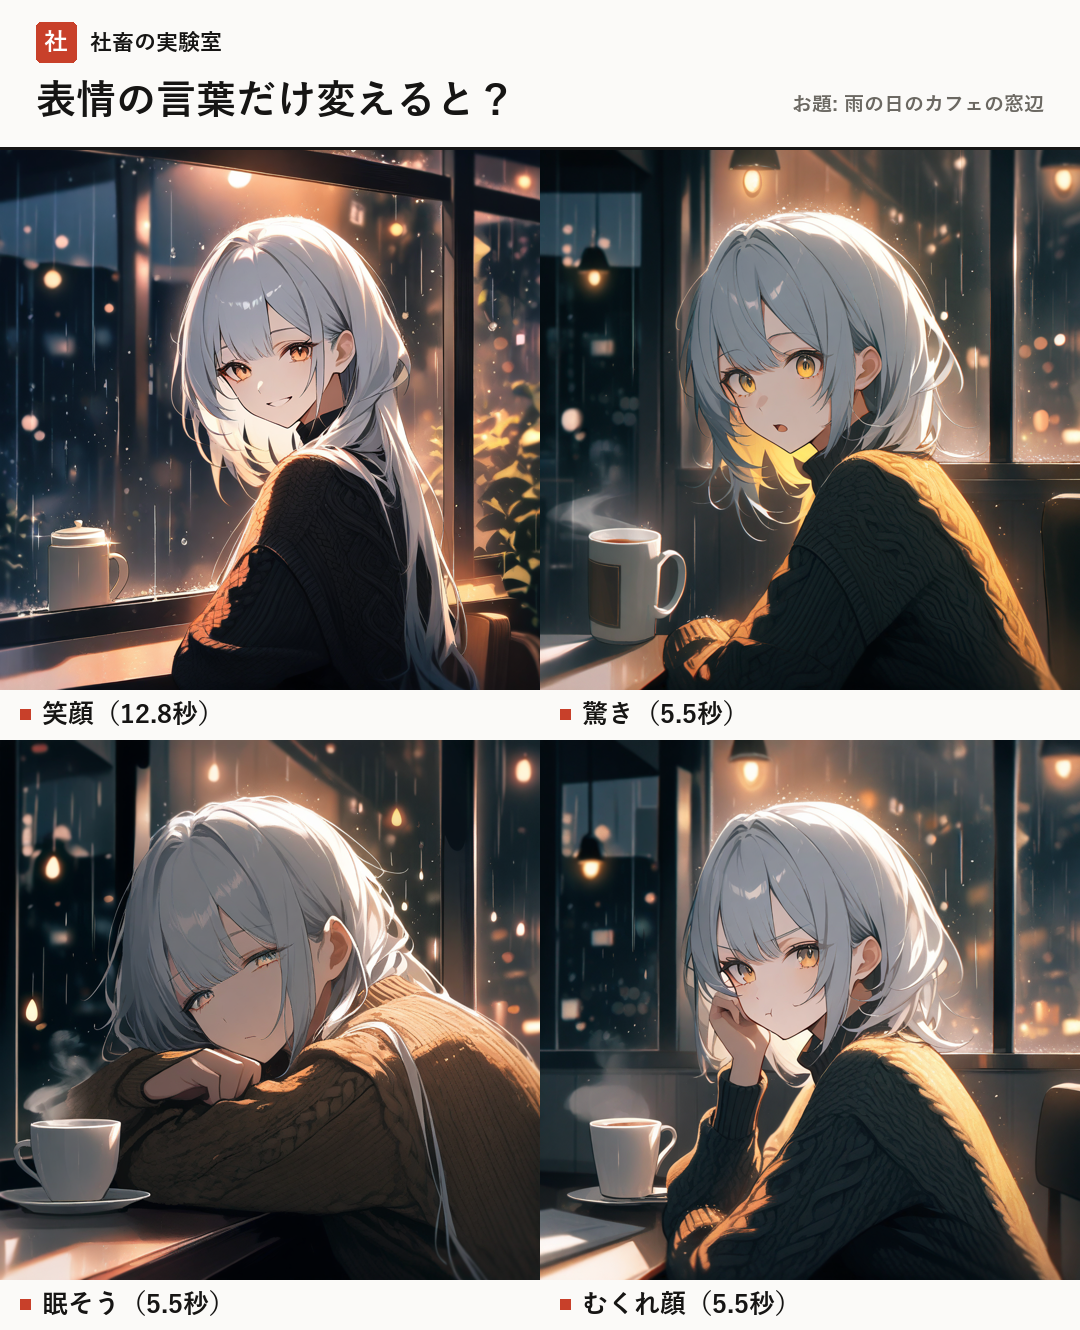
【画像AI】プロンプトの「表情」ひとつで、キャラクターの印象はどう変わる?
画像生成AIにおいて、キャラクターの感情を表現するためのプロンプト(指示文)の書き方と、その変化について実機検証の結果を詳しく解説します。
【カベガミ工房 第2回】風景の中に「謎の二体目」が湧く問題を解決する3段構えの対策
ローカルAIで壁紙を描く際に発生しやすい「意図しない人物の出現」や「体の一部が重複する現象」を、システムとプロンプトの両面から防ぐ具体的な手法を解説します。
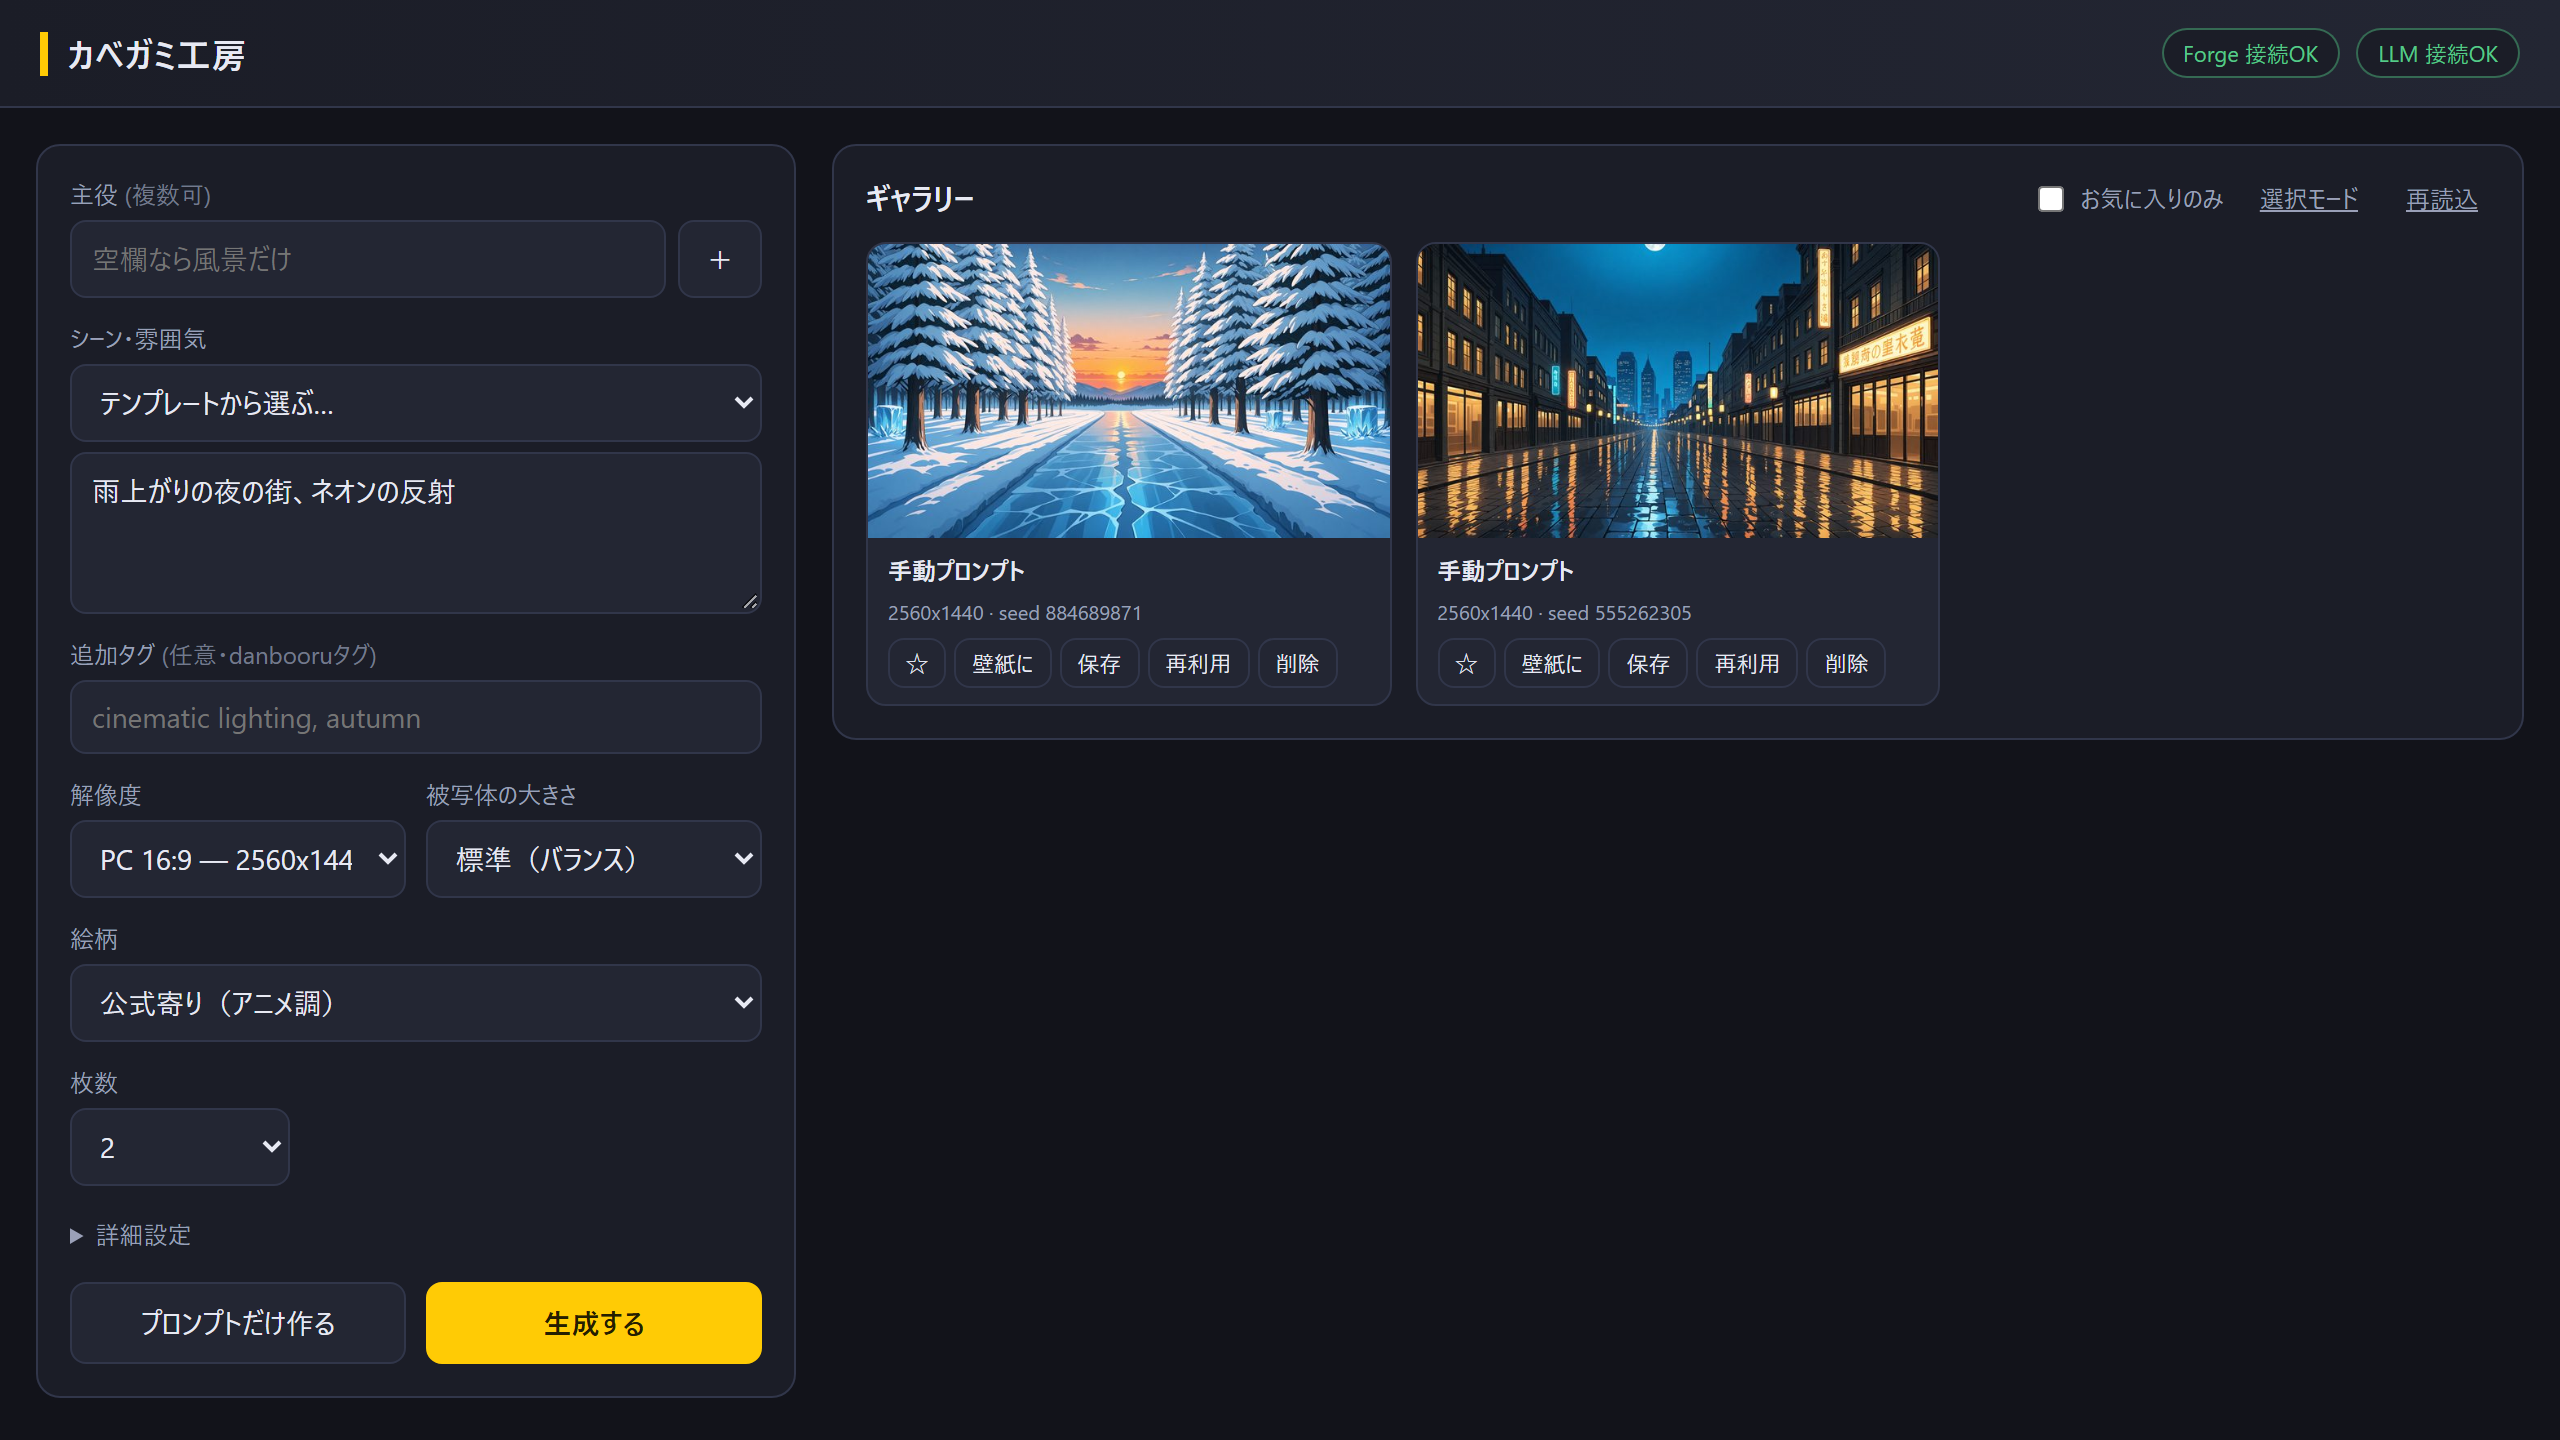
日本語で書くだけで壁紙を生成。ローカルAIで完結する「カベガミ工房」の仕組み
日本語の情景描写から、ローカル環境だけで壁紙画像を生成するツールの仕組みと、メモリ管理の工夫について解説します。
ClineのPlanモードとActモードを使い分ける!Claude Codeのような開発体験を再現する方法
Claude Codeの計画モードに近い操作感を、ClineとローカルLLMの組み合わせで実現する手順を解説します。
メモリ2GB未満でも動作?低スペックPCで動くリアルタイム文字起こしツール「hayamimi」の衝撃
「自分のPCではスペック不足でAIは動かせない」と諦めていた方に朗報です。今回は、驚くほど低いハードウェア要求で動作するリアルタイム文字起こしツール「hayamimi」について、公式情報を基に詳しく解説します。
小さめのローカルAIを使いこなすコツ:指示の具体性が結果を左右する理由
ローカル環境で動かすAI、特に軽量なモデルをより正確に動かすための「指示の出し方(プロンプティング)」の技術について詳しく解説します。
AIが提案したExcel関数でエラーが出る時の対処法:正確な回答を引き出すためのコツ
AIにExcelの相談をするとき、期待した通りに動かずエラーが出てしまうことは珍しくありません。しかし、指示の出し方(プロンプト)を少し工夫するだけで、AIから正しい回答を引き出すことは十分に可能です。本記事では、AIから正確な関数を引き出すための具体的な改善ポイントを解説します。
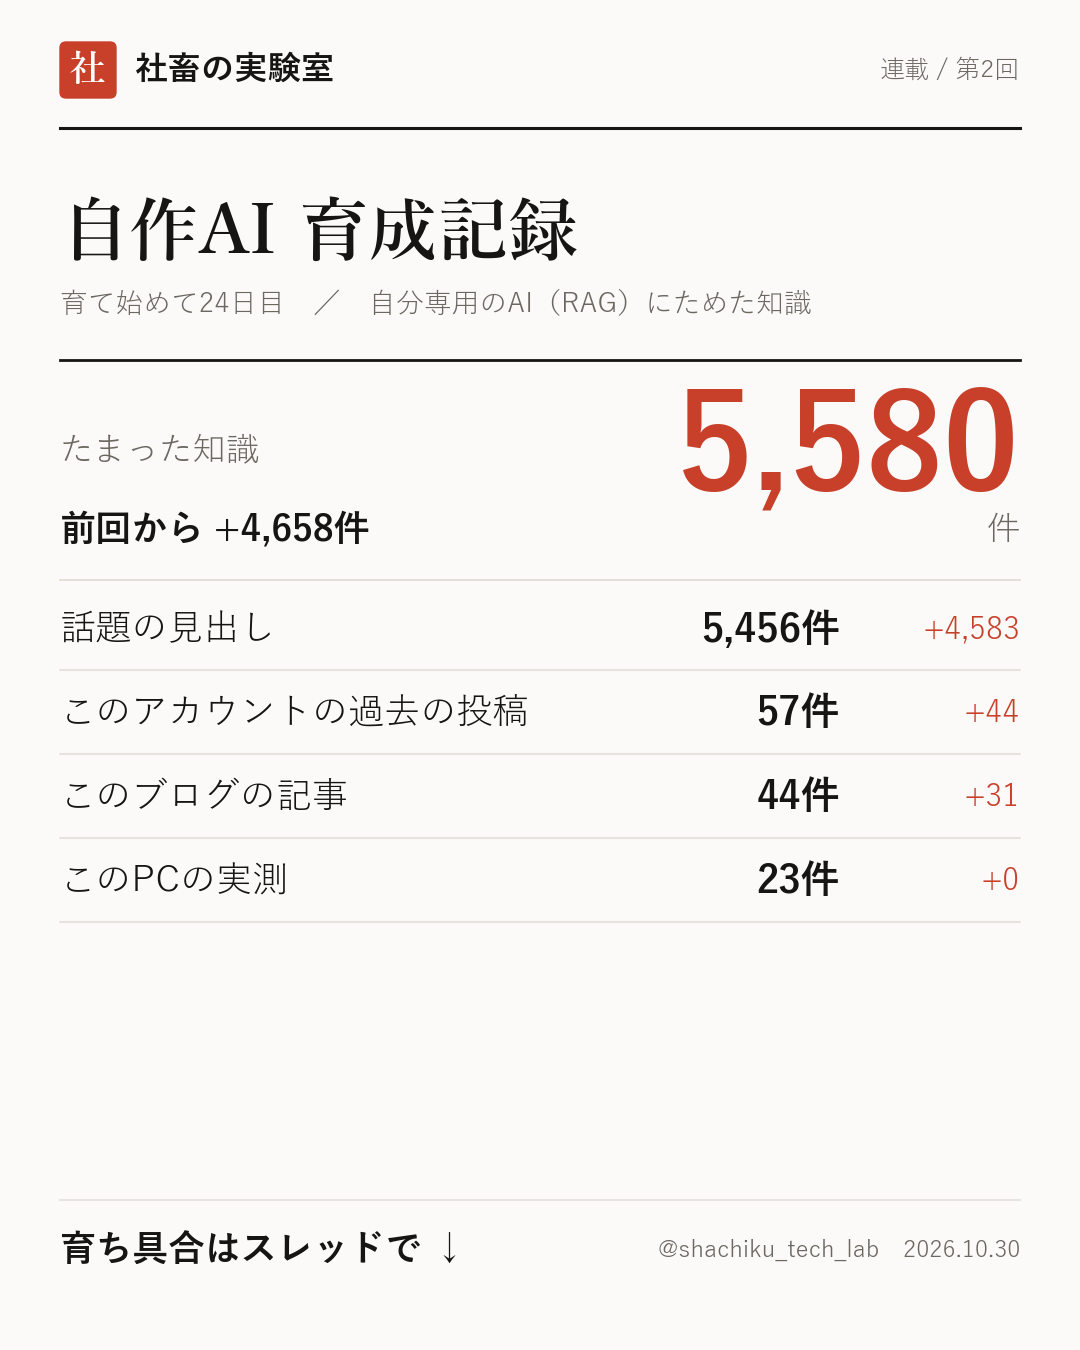
【自作AI育成日記 #2】たった2週間で知識が4658件も増加!自分専用のAIを育てる仕組み
Threadsで公開した「自分専用のAIに知識を蓄積させる実験」の第2回レポートです。RAGという仕組みを使い、どのように知識を収集し、実際にどう活用できているのかを詳しく解説します。
AIのレスポンス待ちを最小化する設計術:『ハヤオシ百科』の裏側にある高速化の工夫
AIを活用したツールを制作する際、ユーザーが最もストレスを感じるのは「待ち時間」です。本記事では、ローカルAIを用いたクイズアプリ『ハヤオシ百科』において、AIの生成待ちをほぼゼロにするために導入した「先読み」と「判定の優先順位」の仕組みを詳しく解説します。
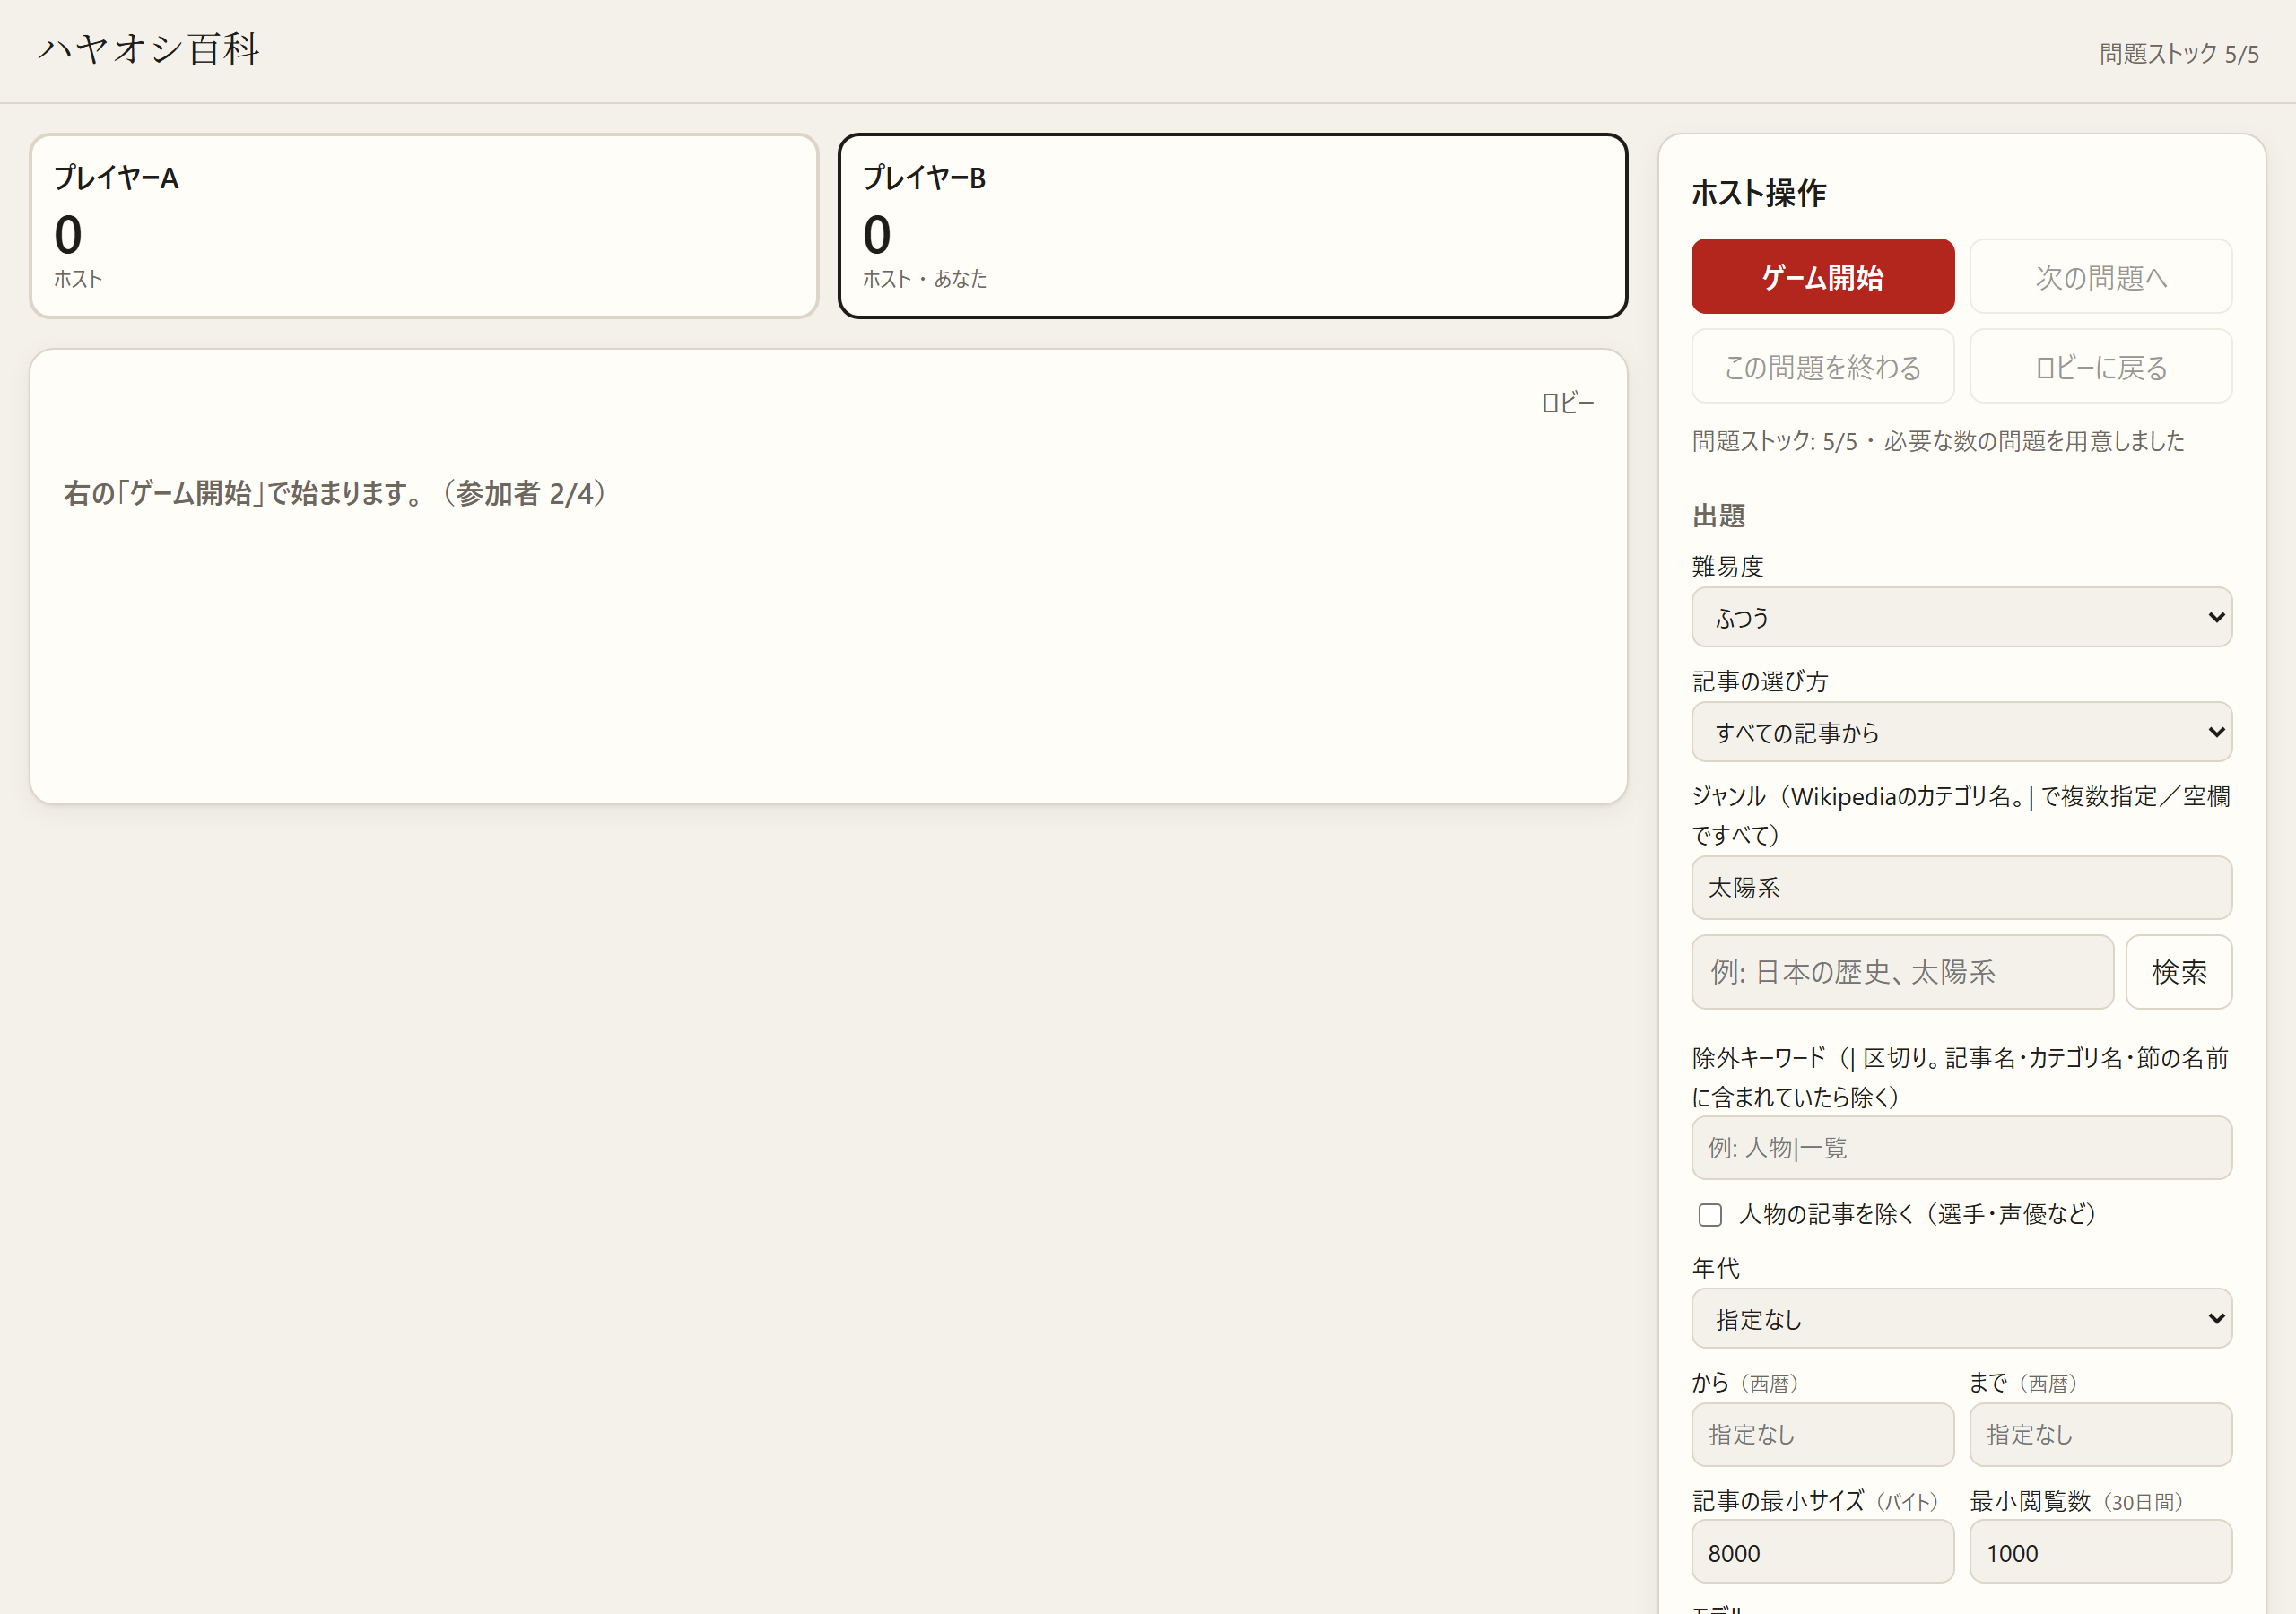
【実験レポート】自宅のPCだけで完結!Wikipediaからクイズを生成する「ハヤオシ百科」を動かしてみた
自宅のPCで動くローカルAIを活用し、Wikipediaの記事を元にリアルタイムの早押しクイズを生成・出題する自作アプリ「ハヤオシ百科」の仕組みと実測結果を詳しく解説します。
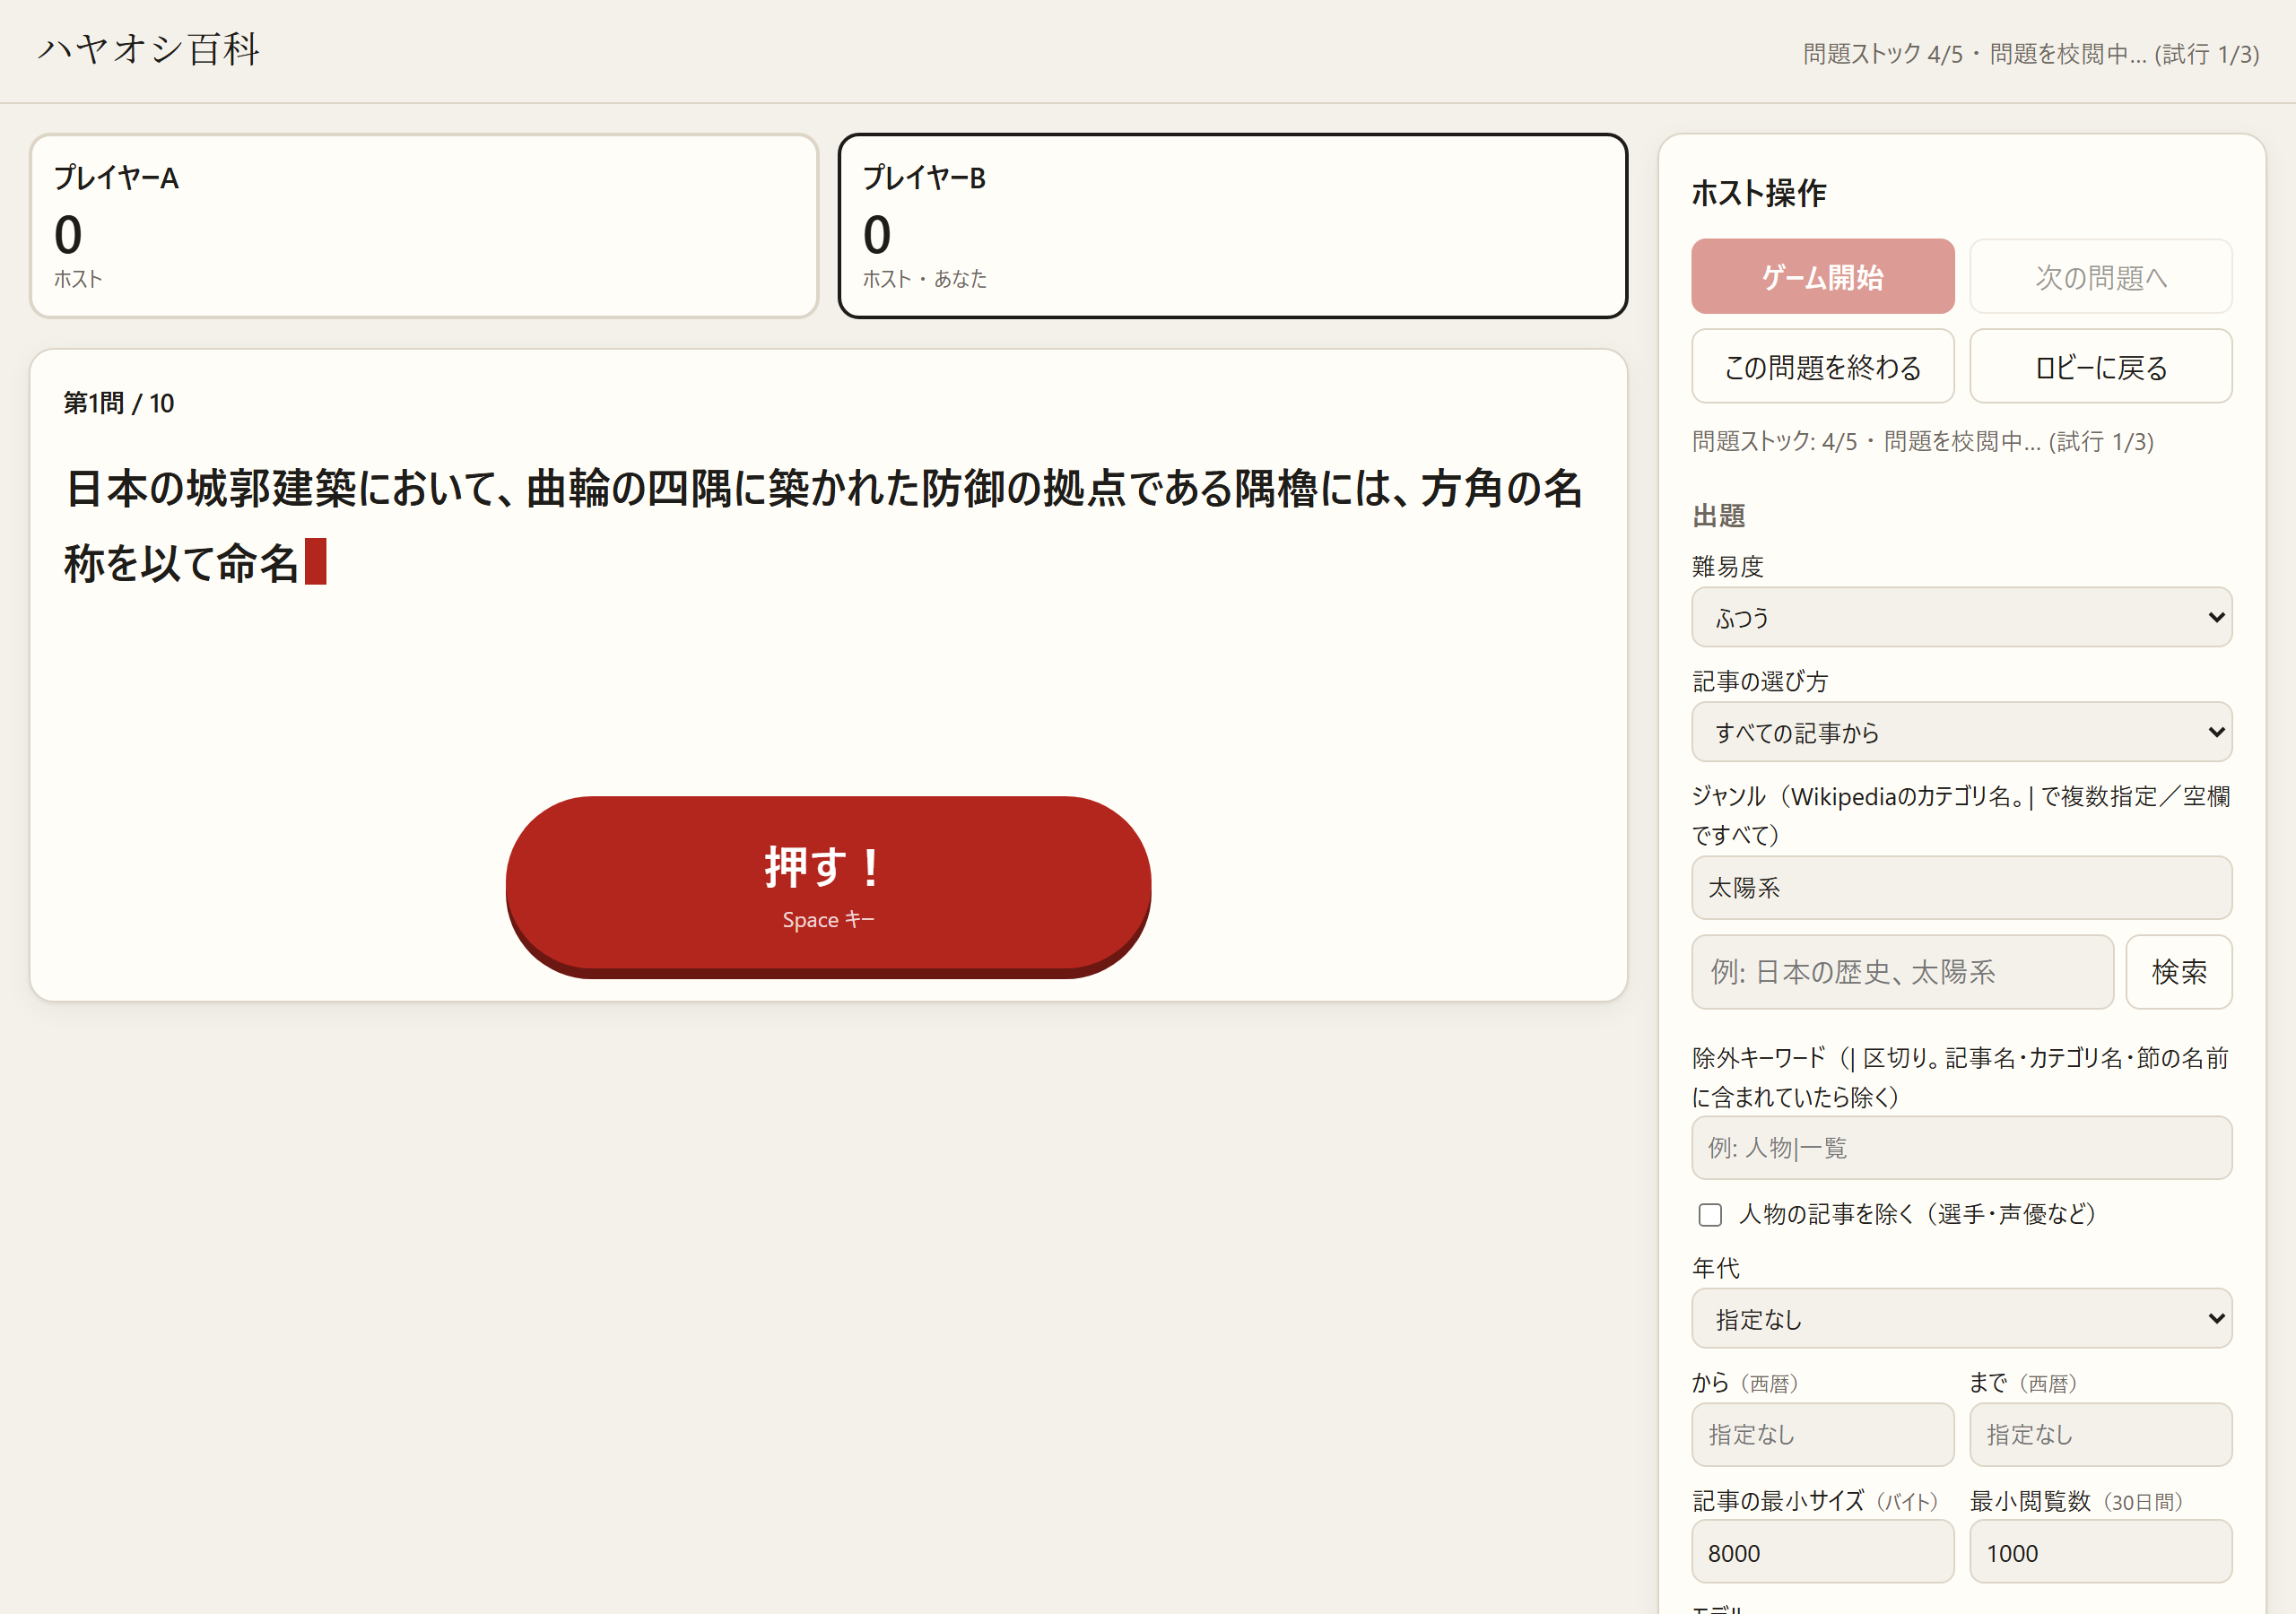
【画像生成AI】シード値ひとつで絵はどう変わる?構成や表情のバリエーションを比較
画像生成AIにおいて重要な概念である「シード値」が、実際の生成結果にどのような影響を与えるかを実機検証した解説記事です。
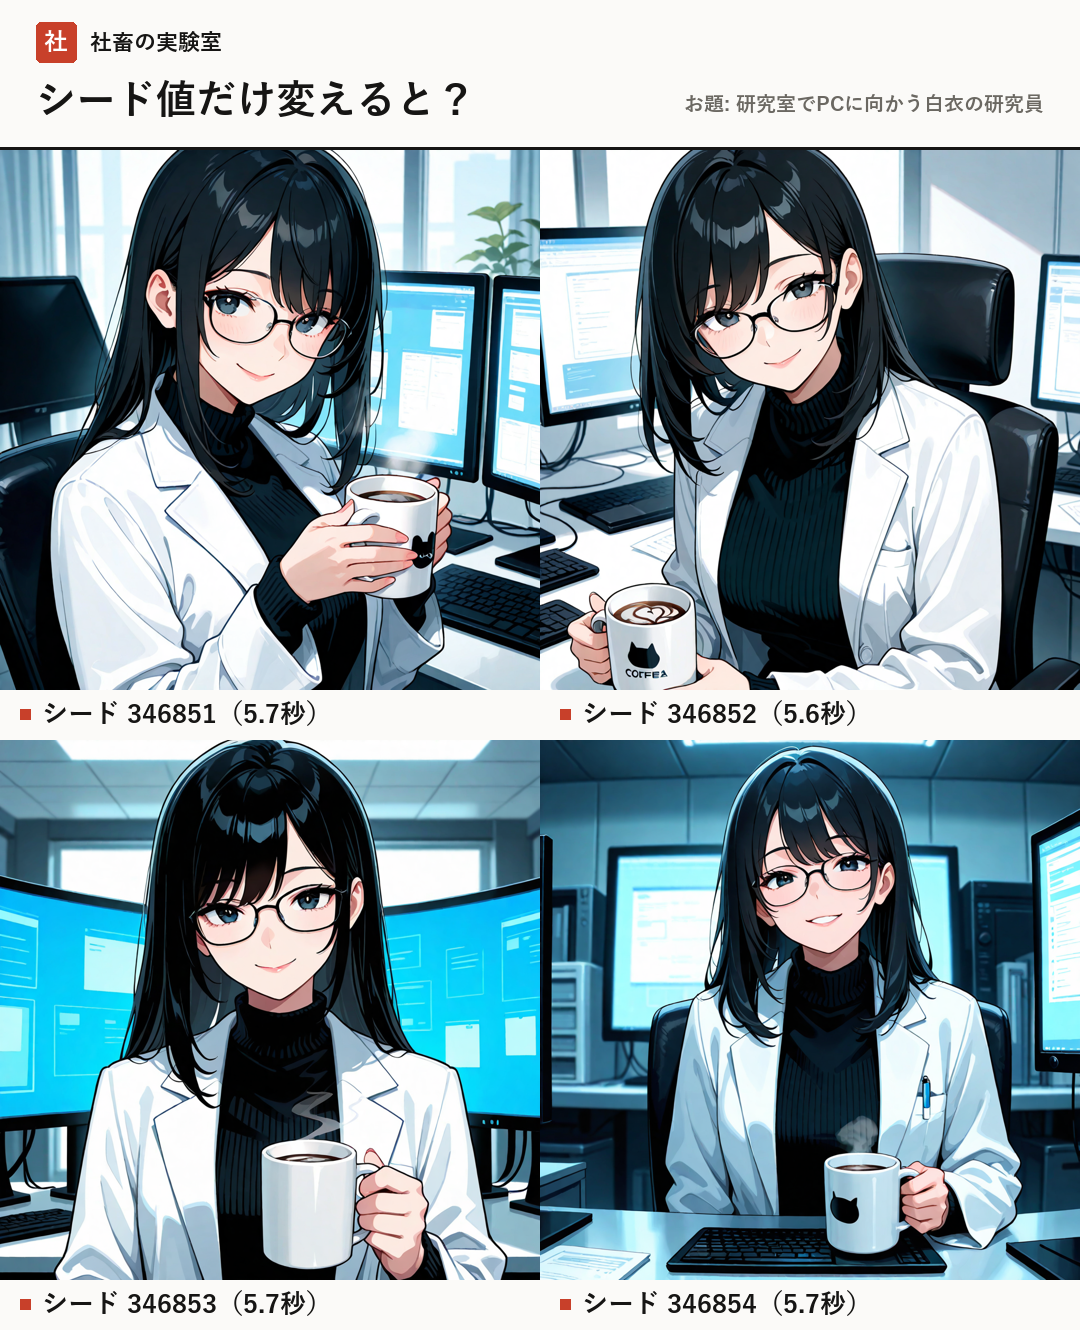
AIの嘘をどう防ぐ?「ハヤオシ百科」が実践する3段階の自動検閲システム
AI(大規模言語モデル)を自分のPCで動かす際に避けて通れない「ハルシネーション(AIがもっともらしい嘘をつくこと)」を、プログラムとAIの二重構造でいかに防いでいるかを詳しく解説します。
メモリ8GBのPCでローカルAIを動かすための実践ガイド:実測データに基づくモデル選び
メモリ容量に制約がある環境で、いかに実用的な速度でローカルAIを動作させるか。実測データに基づいた最適なモデル選びのポイントを解説します。
AIの反応が遅い原因はVRAM不足かも?実測でわかった速度差の正体
自分のPCでAIを動かす際に「なぜか反応が遅い」と感じる原因として多いのが、GPUのメモリ(VRAM)容量の問題です。本記事では、モデルがVRAMに収まっているかどうかが速度にどのような影響を与えるのか、実測データをもとに詳しく解説します。
【AI麻雀道場】「何を切る?」問題をAIで自動生成。初心者でもつまずかないための工夫と仕組みの解説
Threadsで公開した「AI麻雀道場」の最新アップデートについて、初心者の方にも分かりやすく解説します。AI(Claude)を活用して開発したこのツールが、どのように問題を生成し、初心者をサポートしているのか、その裏側をご紹介します。
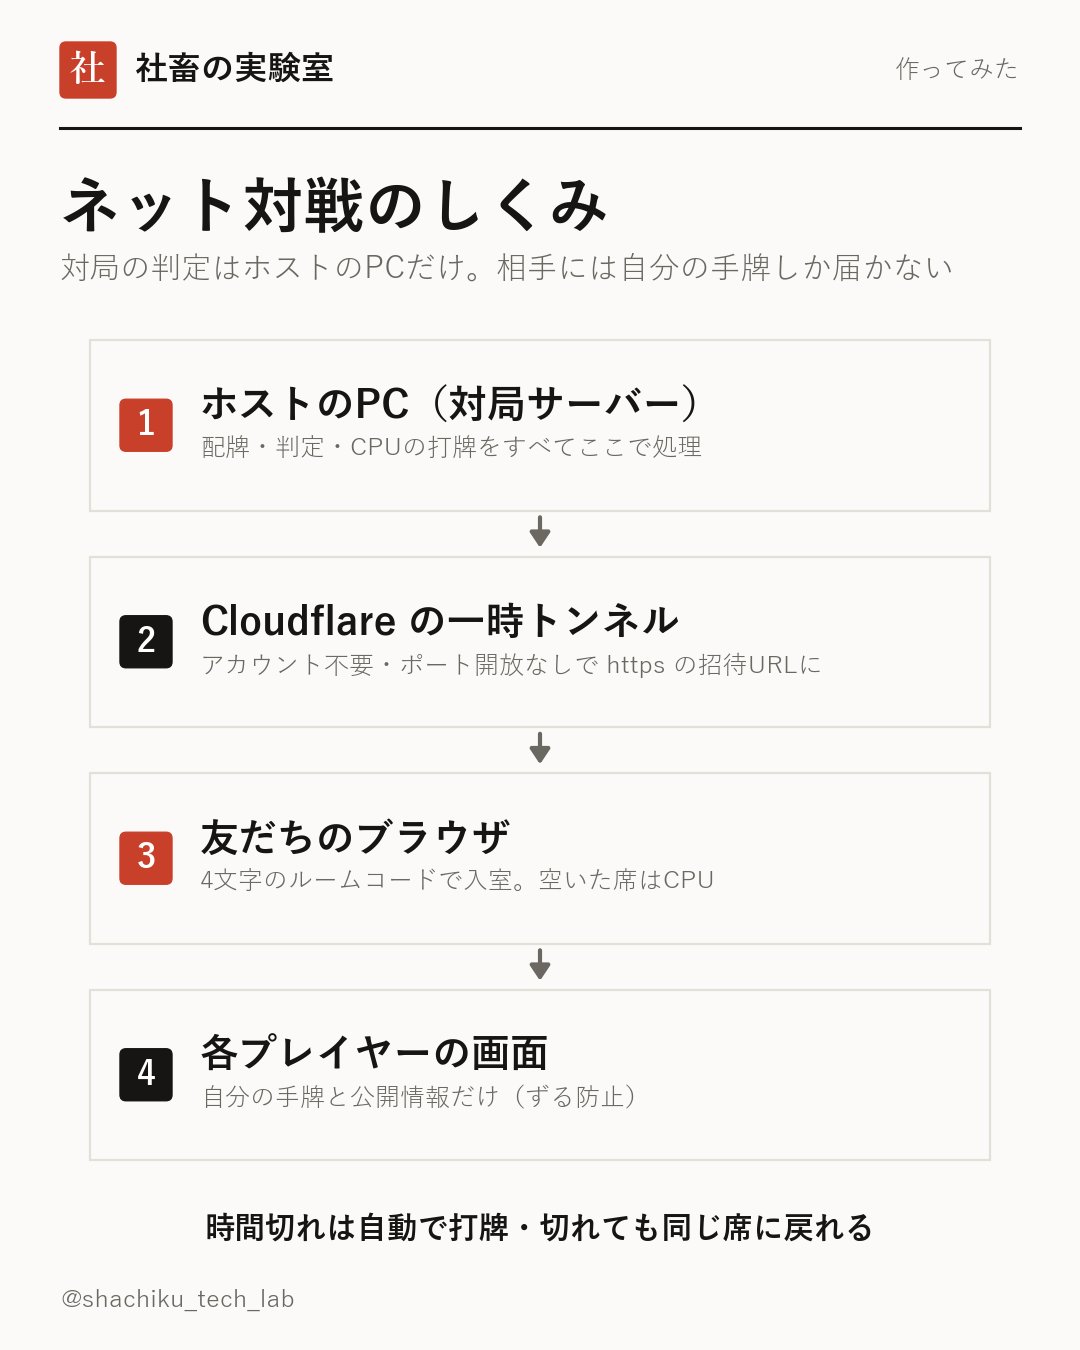
【AI麻雀道場】招待URLを送るだけで友だちと対戦!ネット対戦機能の実装解説
AI麻雀道場の最新アップデートである「ネット対戦機能」について、その仕組みや安全性のテスト結果を詳しく解説します。
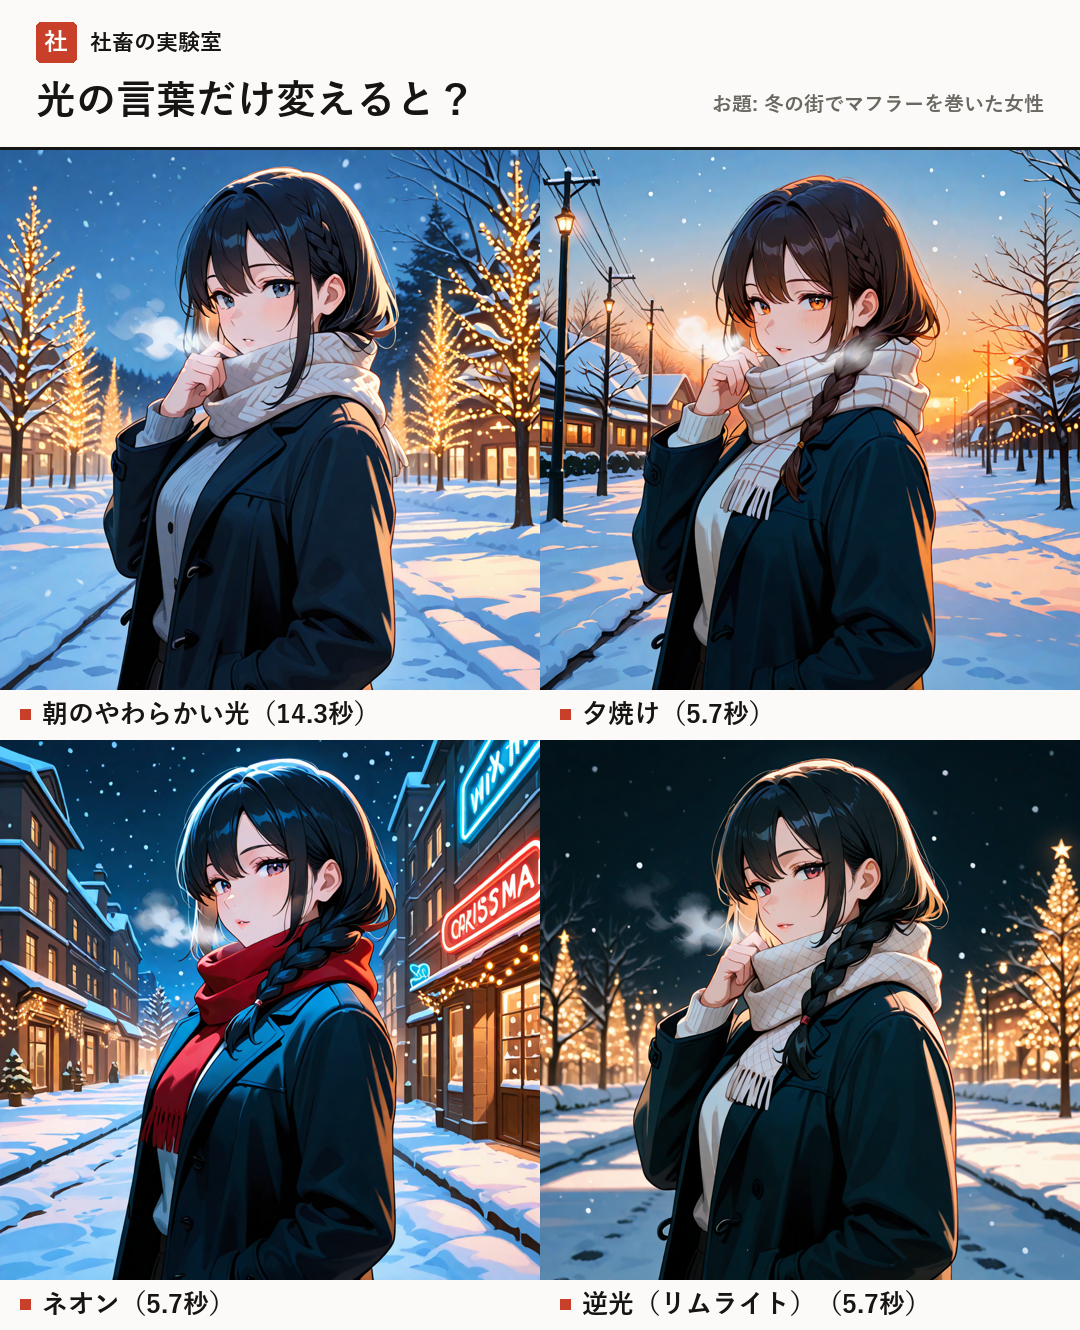
プロンプトの「光」の言葉を入れ替えるだけで、画像の世界観はここまで変わる
画像生成AIにおいて、キャラクターの造形だけでなく「光の当たり方」をコントロールする手法について、実測データをもとに解説します。
【連載最終回】AIに長編物語を記憶させるコツと、失敗しないモデル選びの基準
「AIに長い話をさせると、途中で最初の方の設定を忘れてしまう……」そんな悩みをお持ちの方へ。自作ツール「ナラテーブル」の開発過程で判明した、AIの記憶力を維持する仕組みと、ローカル環境で動かす際の重要な注意点を解説します。
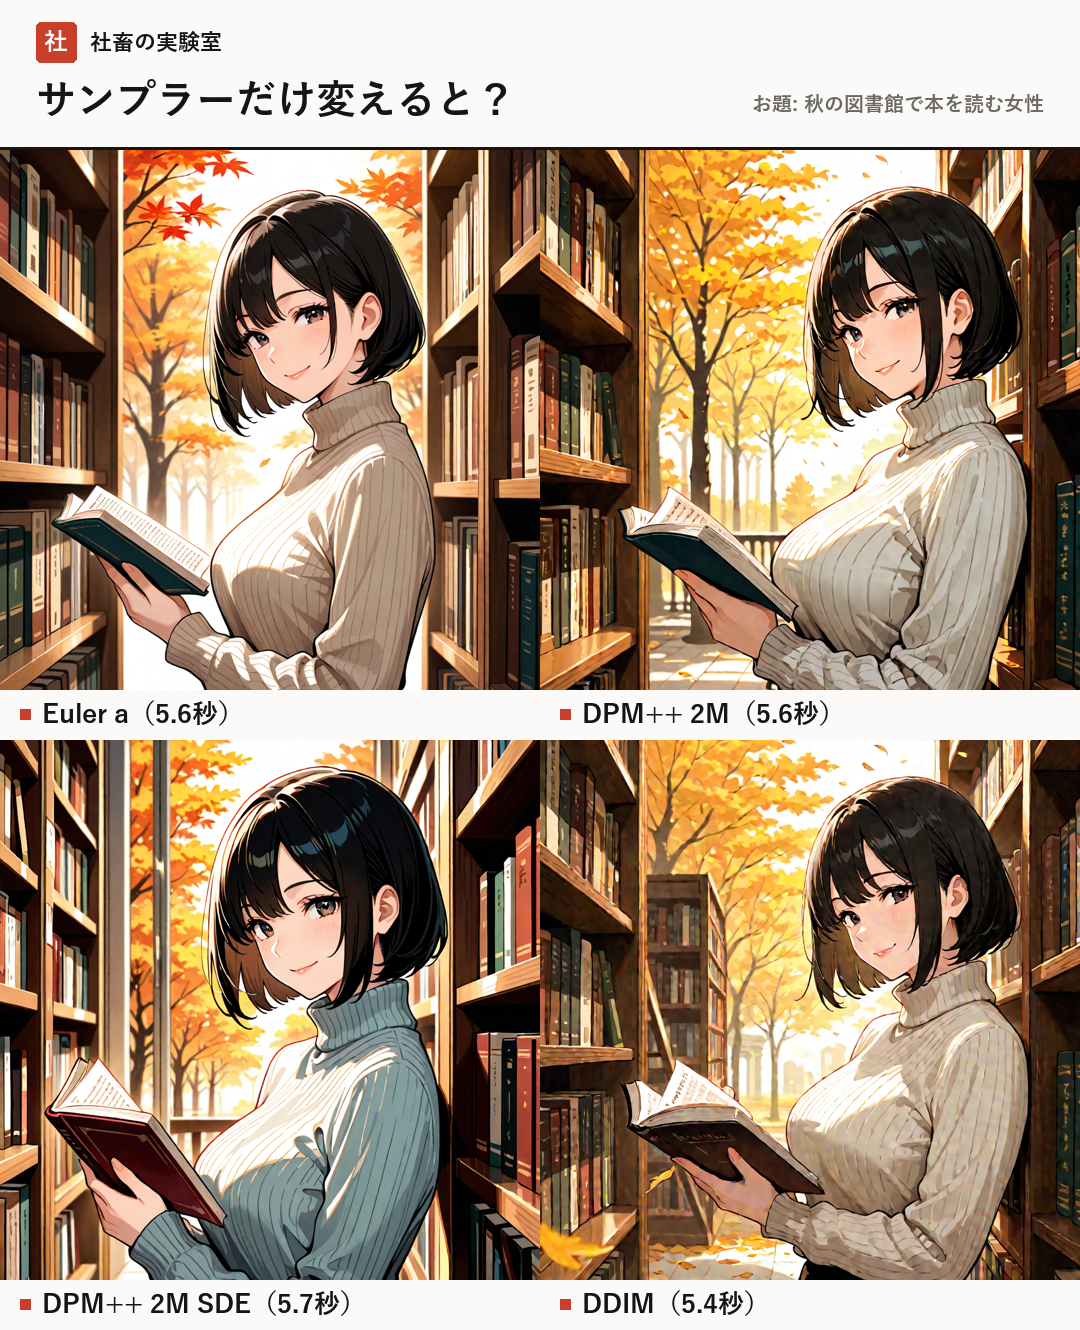
【画像生成AI】サンプラーを使い分けるだけで、絵の質感はどう変わるのか?
画像生成AIにおいて、同じプロンプト(指示文)やモデルを使っていても、出力される絵の雰囲気が変わる要因の一つに「サンプラー」があります。本記事では、特定のキャラクターを題材に、4種類のサンプラーを比較した実験結果を詳しく解説します。
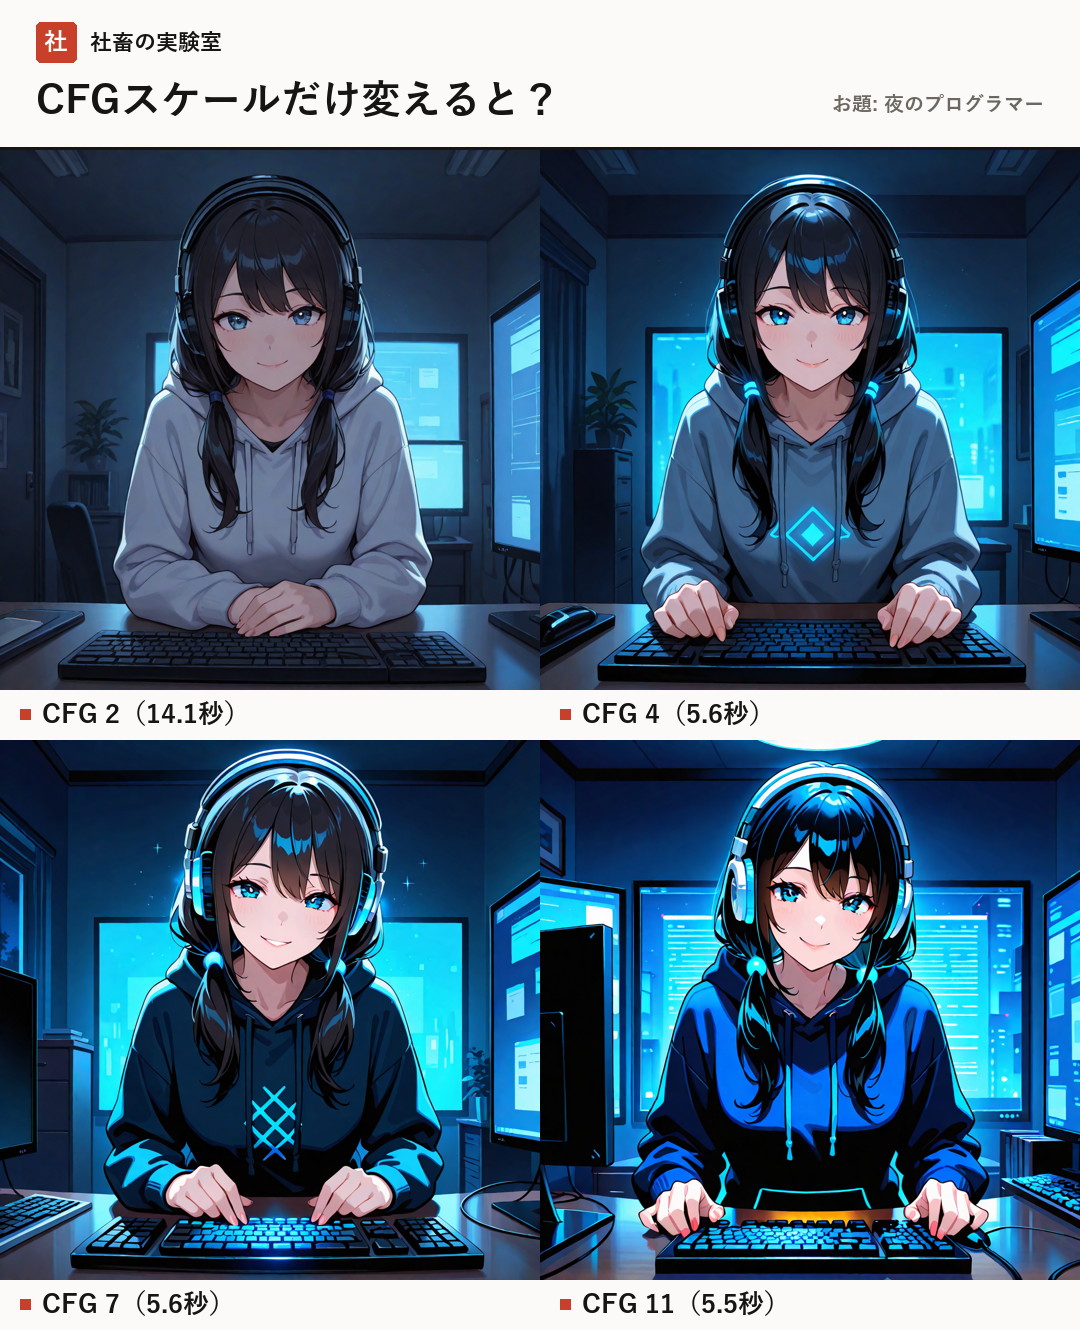
【画像AI】CFGスケールひとつで変わる!指示の「忠実度」を調整するコツ
画像生成AIにおいて、プロンプトへの従順さを制御する「CFGスケール」の設定が、生成される画像の雰囲気や色の濃さにどのような影響を与えるかを実験結果をもとに解説します。
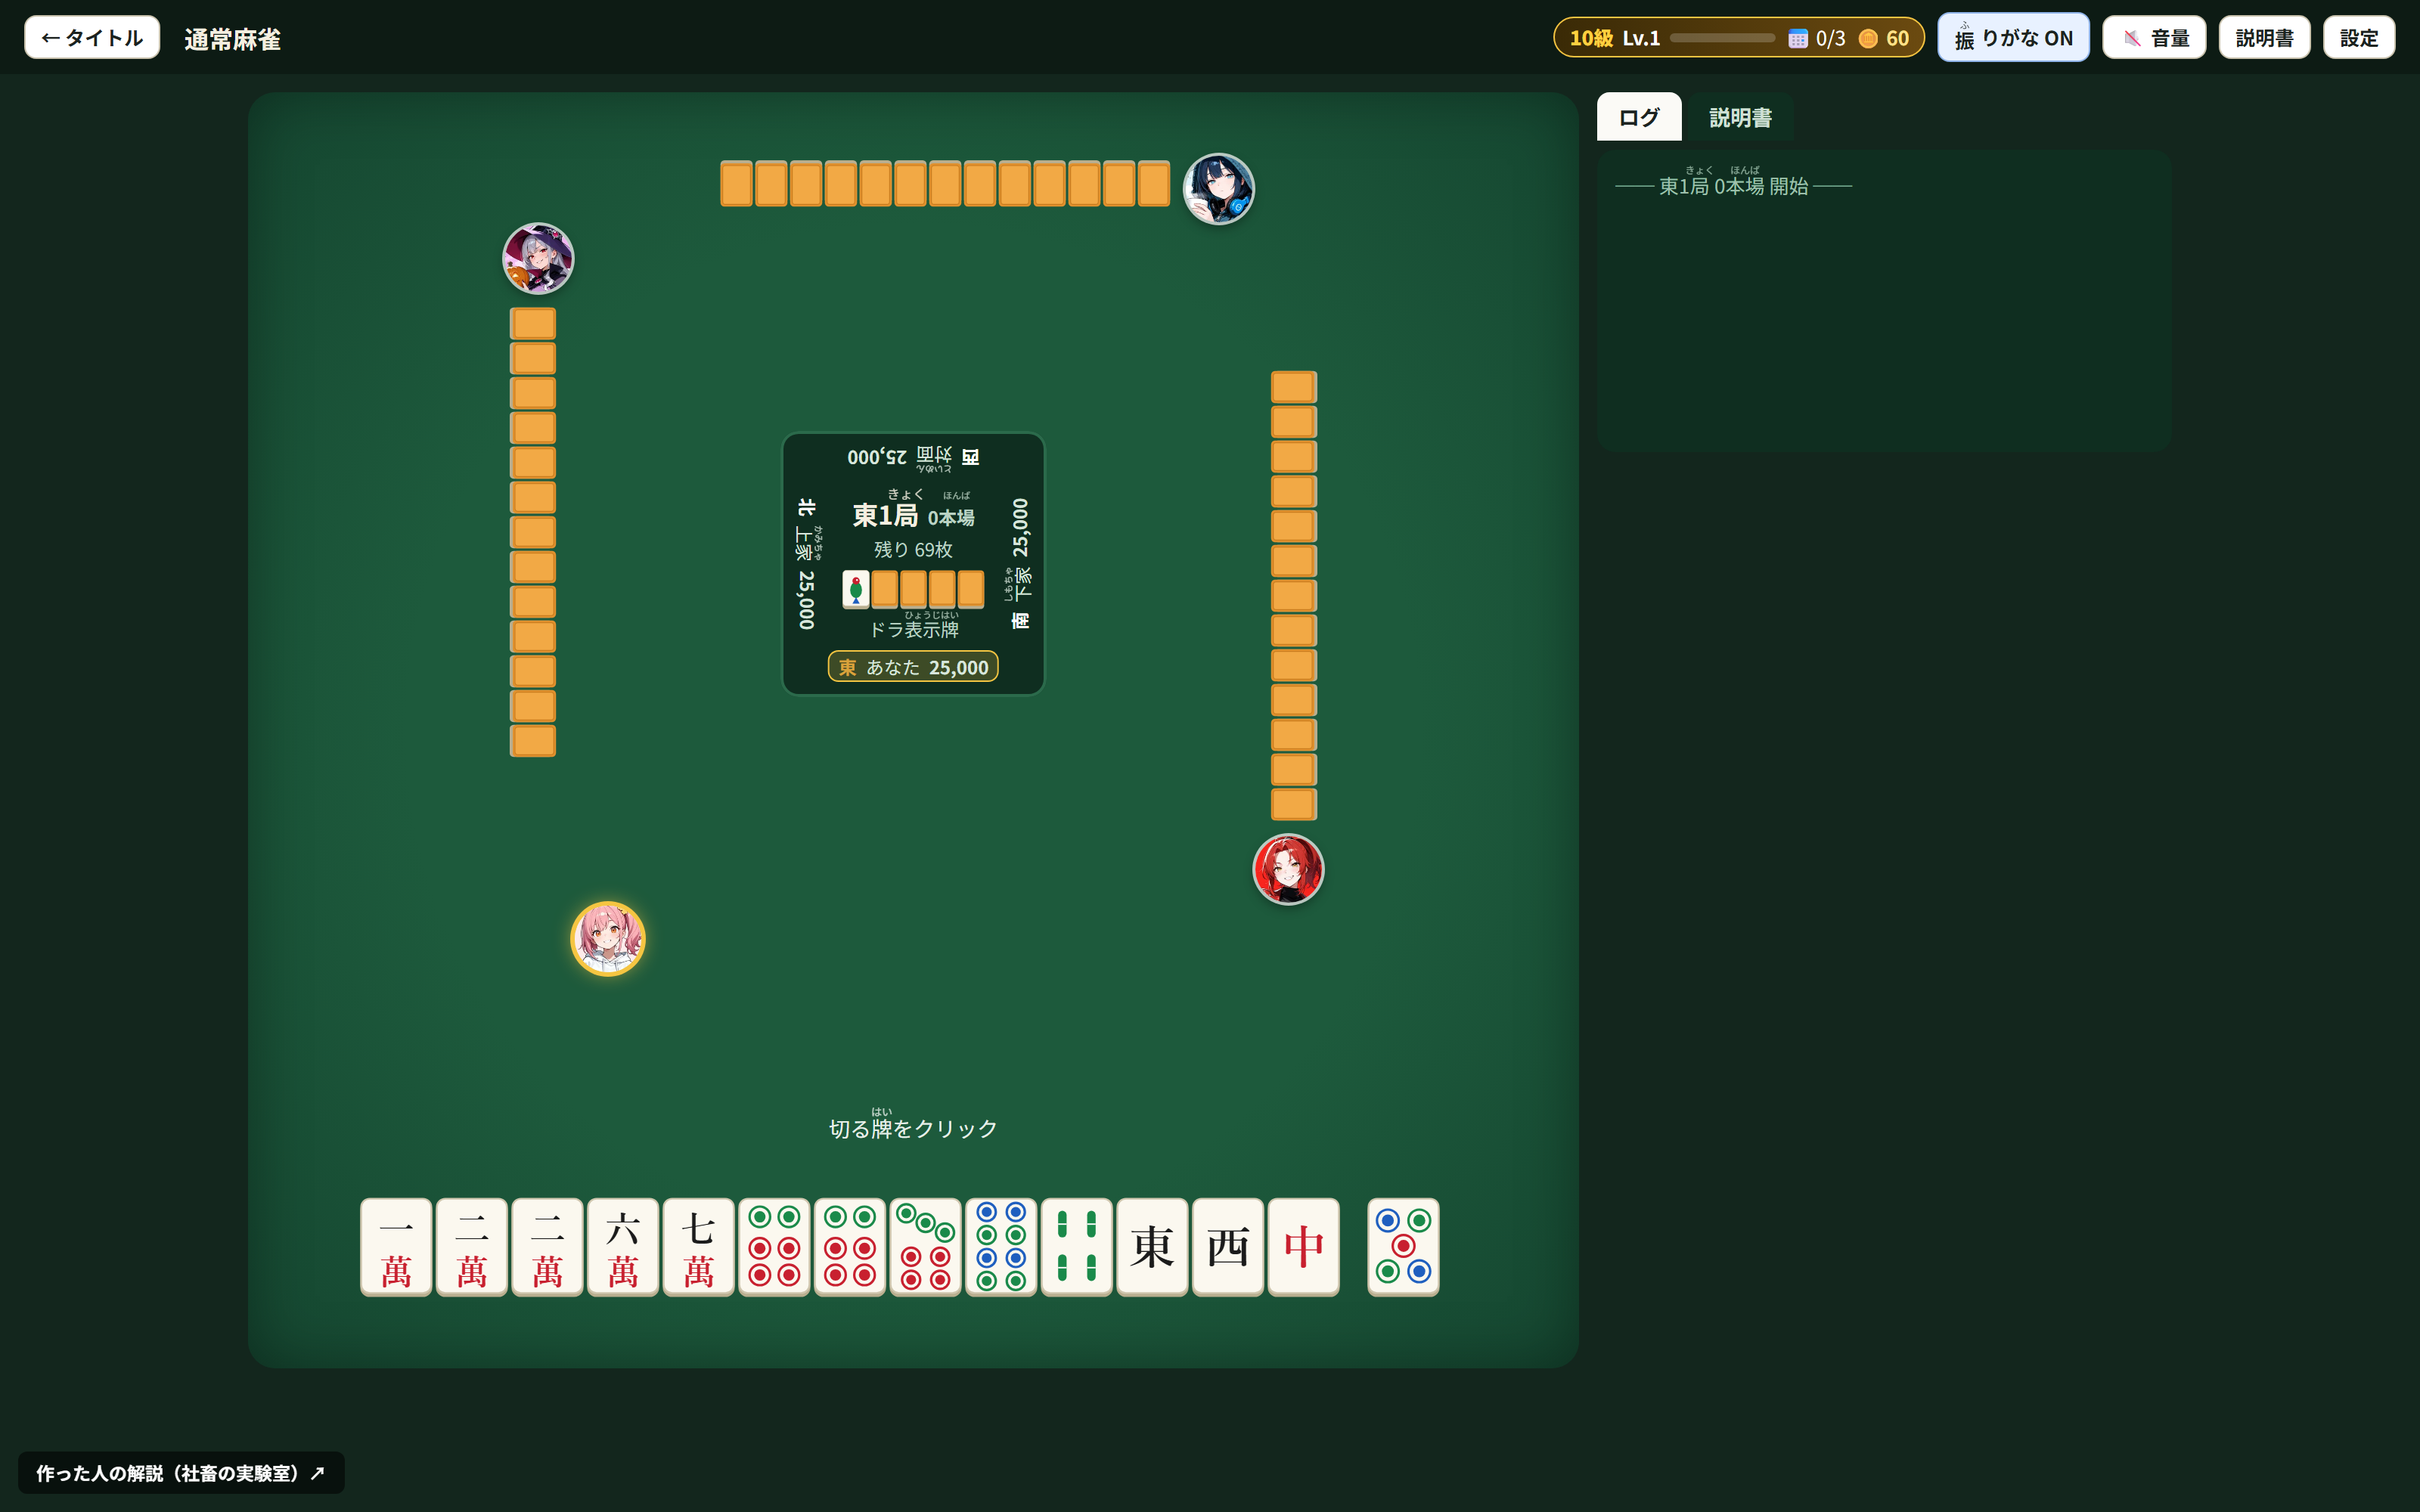
AI×ゲーム性の融合:学習を「遊び」に変える演出と成長システムの秘密
AI麻雀道場の開発過程で取り入れた、ユーザーのモチベーションを維持するための「ゲーム的演出」と「成長システム」について詳しく解説します。
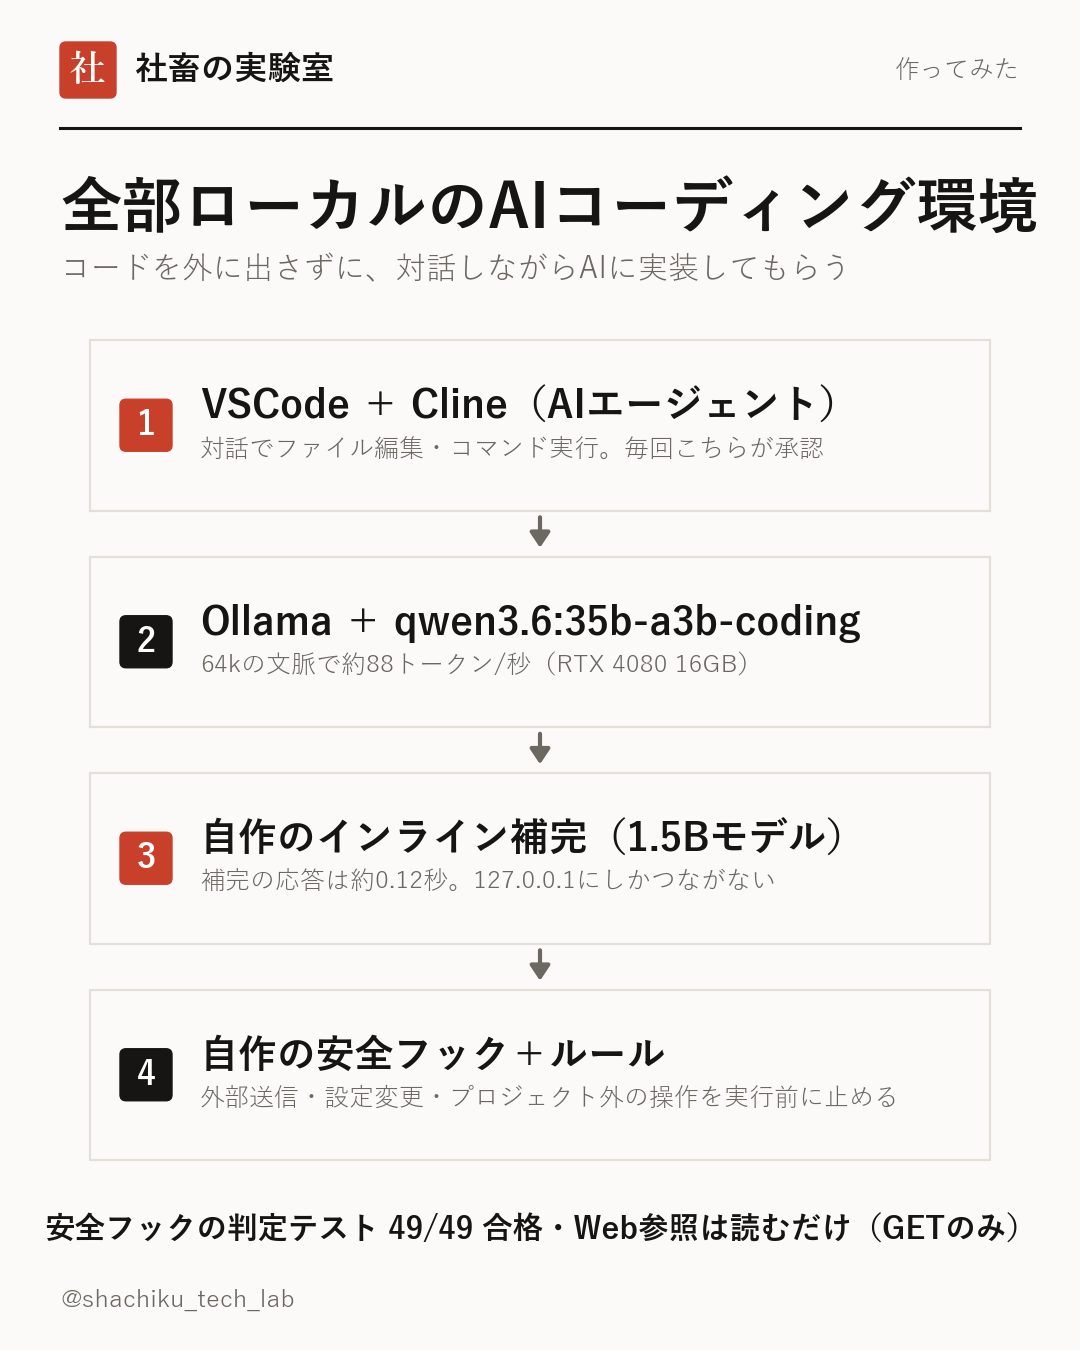
ローカルLLMでAIコーディング環境を作る|Cline+Ollamaで外部送信なし・実測88トークン/秒
VSCode の Cline と Ollama(qwen3.6:35b-a3b-coding)で、コードを外部に送らないAIコーディング環境を作った記録。RTX 4080 での実測速度、外部送信を防ぐ設定、AIエージェントを止める自作の安全フック、自作のインライン補完までまとめました。
VRAM 16GBの限界に挑む!文章AIと画像生成を共存させるための「メモリ譲り合い」の技術
自前でAIを動かす際に必ず直面する、ビデオメモリ(VRAM)の容量不足。RTX 4080(16GB)という中堅以上のスペックを使いながら、文章生成と画像生成の両方をストレスなく両立させるための具体的な工夫と、技術的な課題解決の手法を解説します。
【解説】AIだけでキャラのボイスと衣装を完全自作する仕組み
「AI麻雀道場」の第3回で公開した、AIを活用したキャラクター制作の裏側を詳しく解説します。自分のPC(ローカル環境)だけで完結させるためのポイントをまとめました。
Excel関数をAIに正確に聞き出すための3つのポイント
「AIに聞いても、思うような関数が返ってこない」と感じている方へ。情報の伝え方を工夫することで、AIを強力な業務の相棒にするための具体的な手順を解説します。
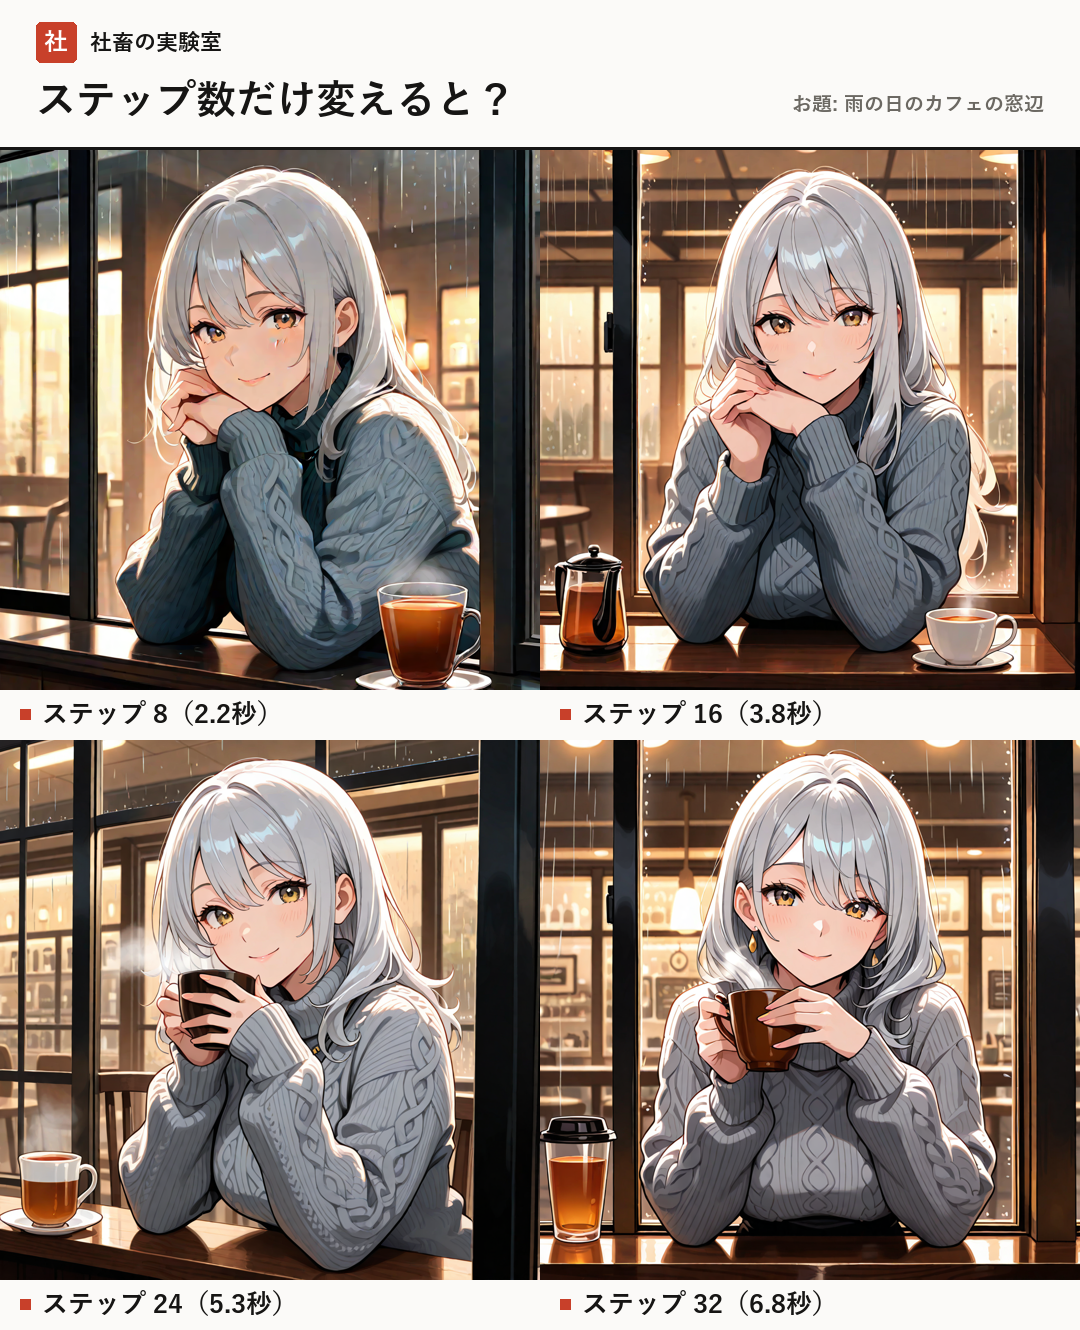
画像生成AIにおける「ステップ数」の影響とは?描き込みの密度と生成時間の関係を検証
Stable Diffusionを用いた画像生成において、基本的なパラメータである「ステップ数」を変化させた際に、描写の仕上がりや生成時間にどのような違いが生じるのかを解説します。
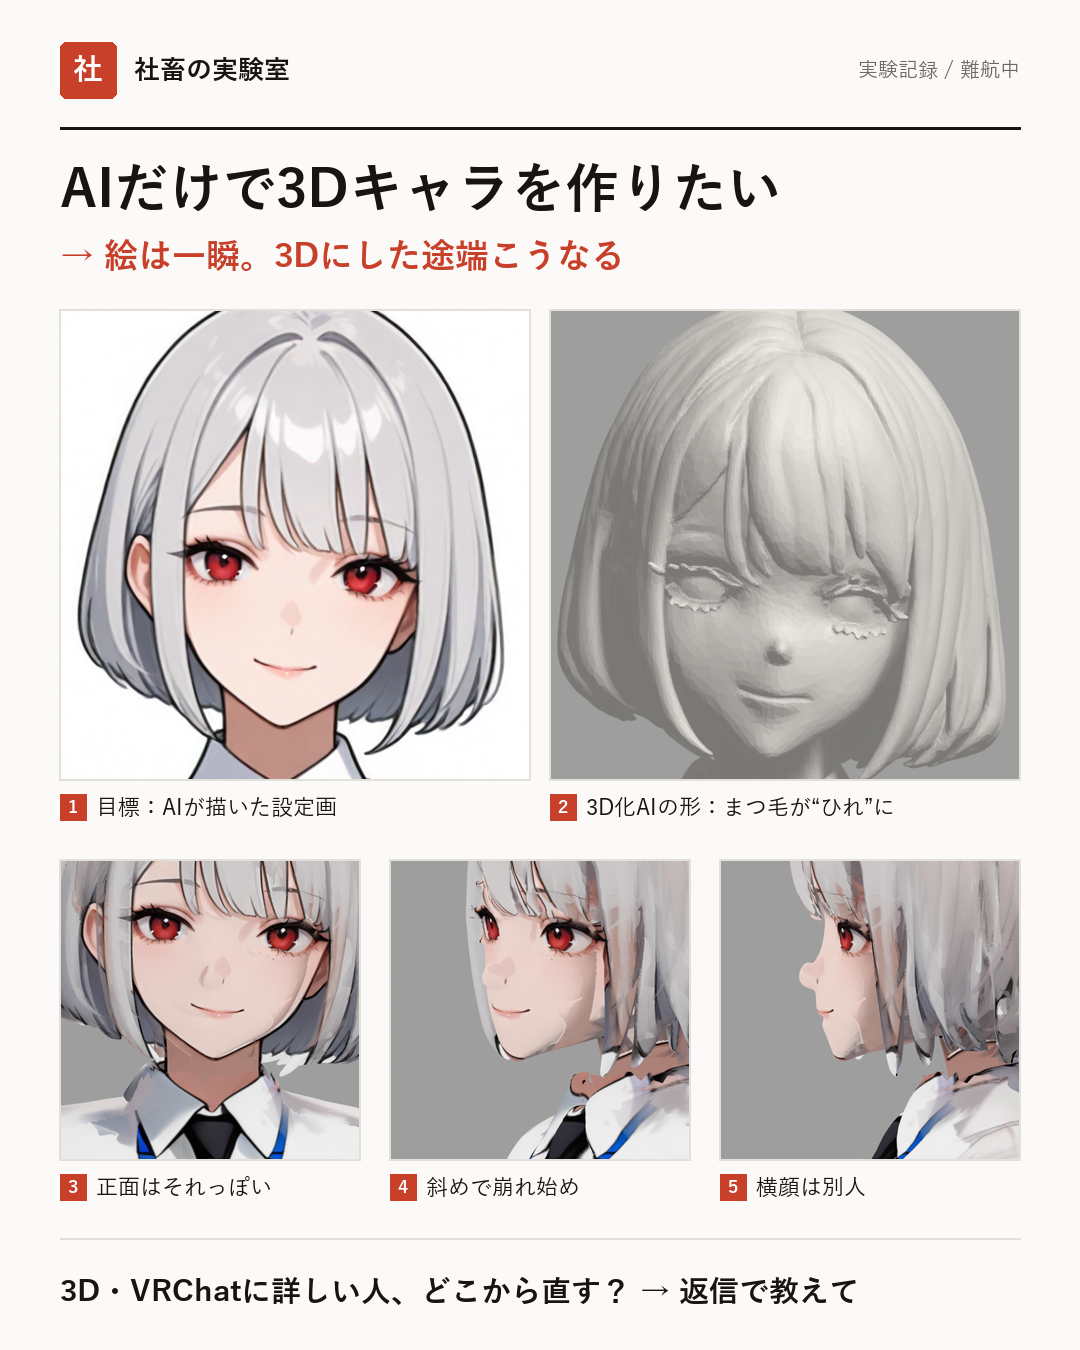
画像から3DキャラをAIで作る|Hunyuan3D-2.1でVRChatアバターに挑戦した失敗と対策
画像生成AIで描いた設定画を Hunyuan3D-2.1 で3Dモデルにし、VRChat アバターを目指す挑戦の記録。横顔が崩れる理由、3D化AIのあるある失敗6つ、自動リギング(SkinTokens)の結果、次の作戦をまとめました。
AI麻雀道場 第2回:判断はエンジン、言語化はLLM
ローカルAIを活用して麻雀を学ぶツール「AI麻雀道場」の開発秘話。なぜLLMにすべてを任せてはいけないのか、正確な解説を実現するための「役割分担」の仕組みについて詳しく解説します。
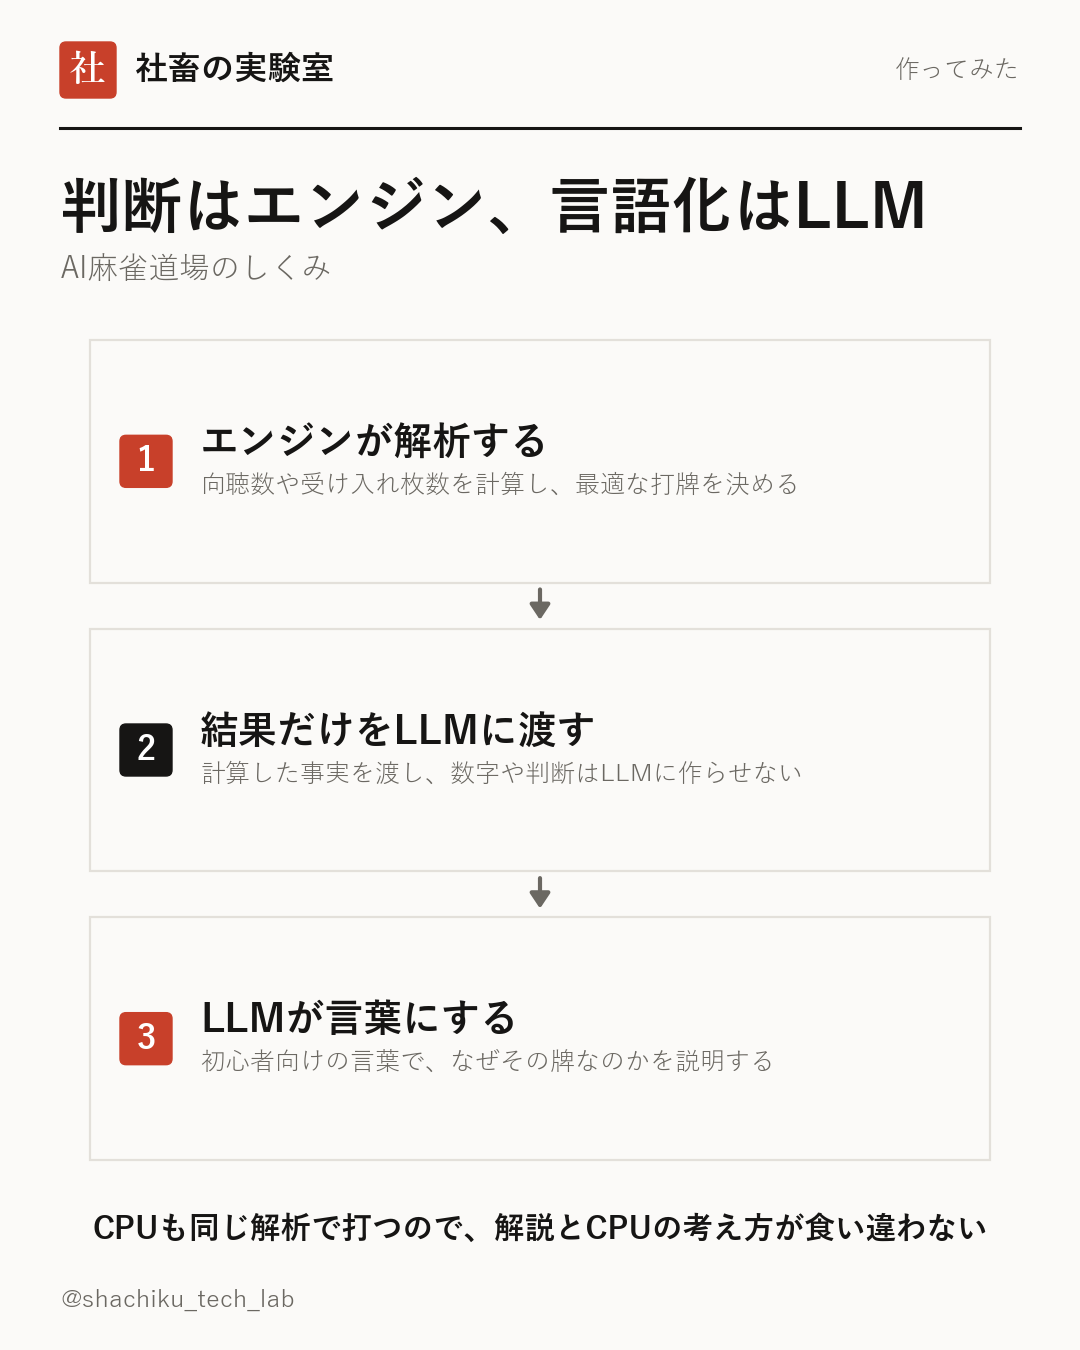
AIコーチがリアルタイムで教える!ブラウザで動く「AI麻雀道場」の仕組み
Threadsに投稿された『AI麻雀道場』の紹介内容をもとに、初心者の方にも分かりやすく解説したブログ記事です。ローカルLLMを活用して、自分の打牌に対してAIがリアルタイムに添削してくれる仕組みを詳しく紐解きます。
自分専用のAIを育てる。知識922件の蓄積とRAGによる情報の自動抽出
毎日話題のニュースや自分の経験をAIに学習(蓄積)させ、必要な時にだけ引き出せる仕組みを構築する「自作AI育成」の第一歩について解説します。
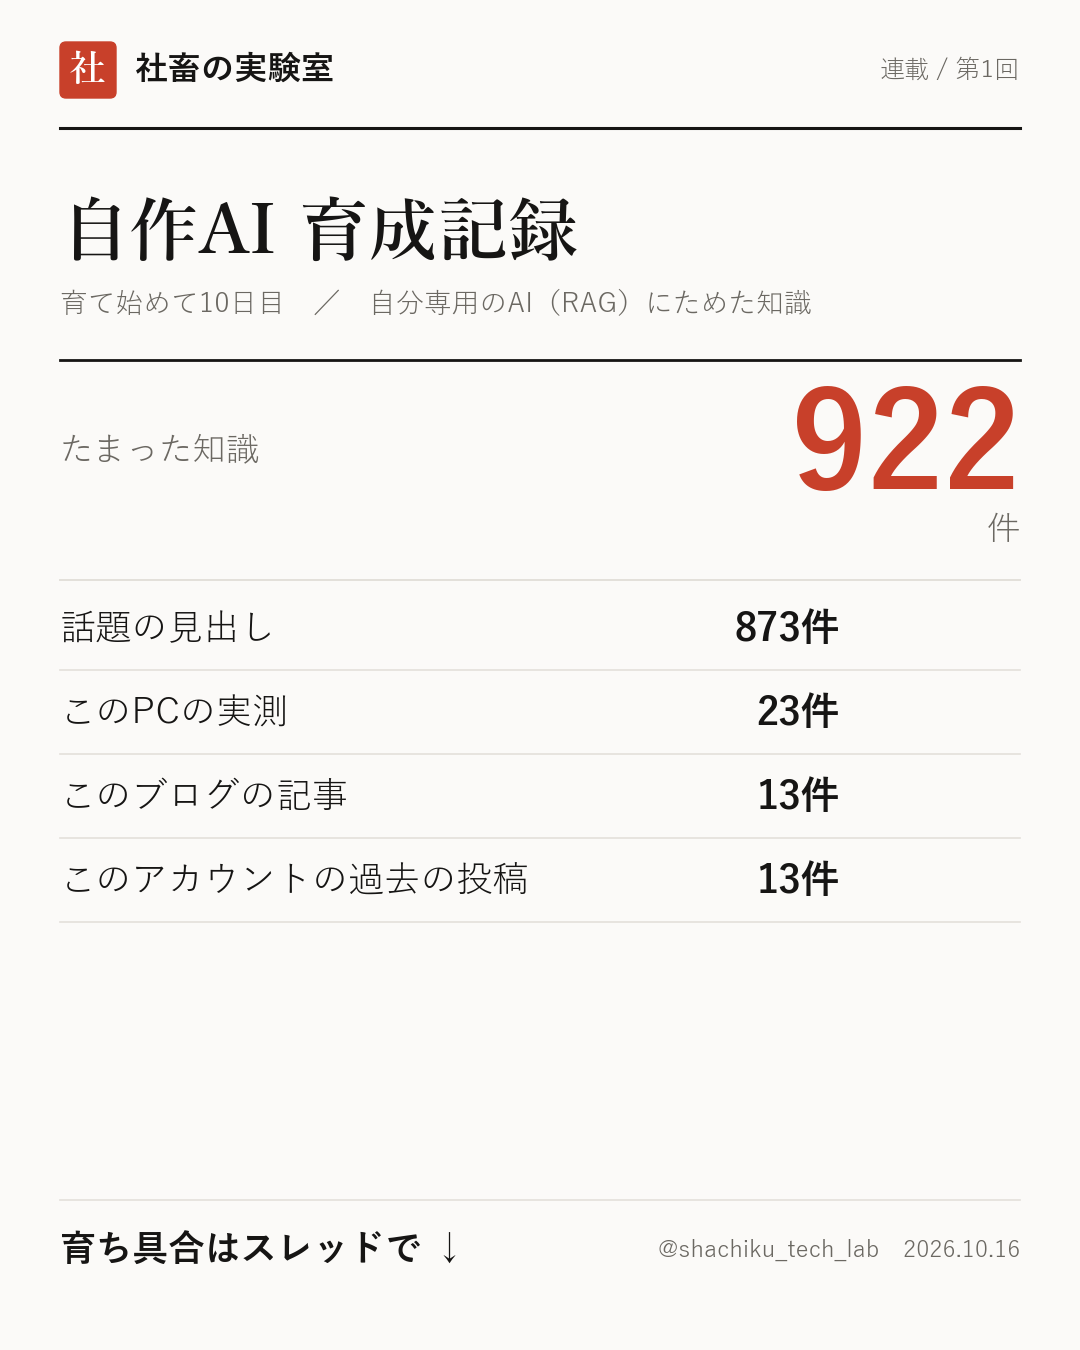
AIの返事を単調さから救う「枠」の設計:ナラテーブルにおける制約の工夫
AIとの対話において、返答の長さや内容がパターン化してしまう問題を解決するための具体的なアプローチを解説します。
画像生成AIにおける表情の指示:単語ひとつで変化するキャラクターの印象
プロンプト(AIへの指示文)に加える「表情」に関する単語が、生成される画像の細部にどのような影響を与えるかを検証しました。
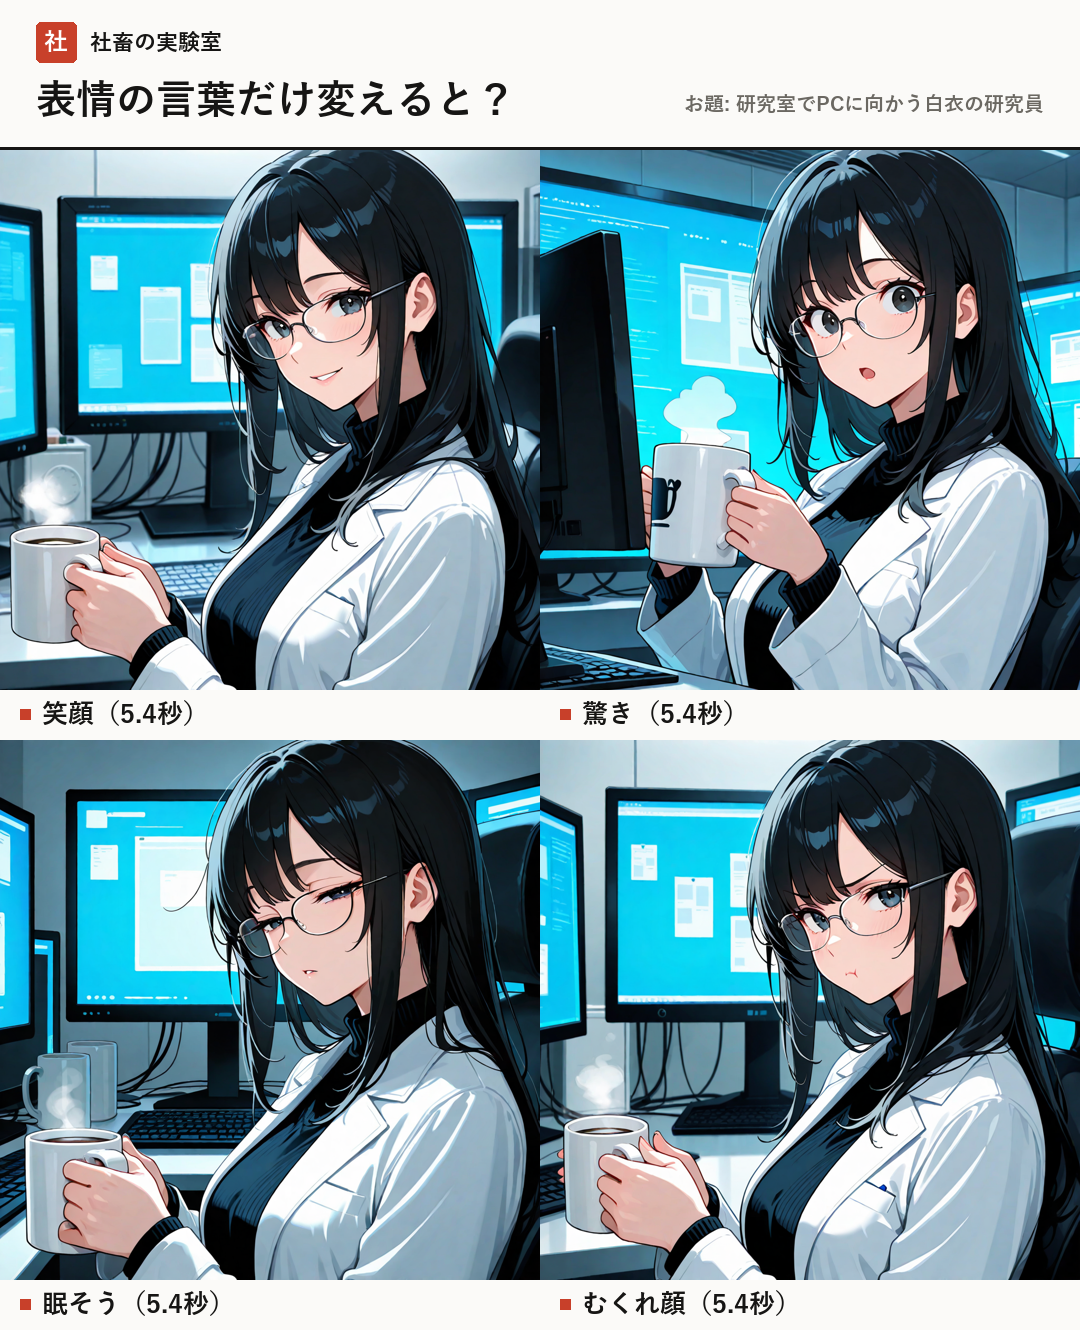
【実測レポート】画像生成AI(Stable Diffusion)を自分のPCで動かす際の速度とVRAM消費量の目安
ローカル環境で画像生成AIを動かしたいと考えている方に向けて、具体的なGPUスペックとモデルごとの動作検証結果を詳しく解説します。
CPUのスレッド数を制限しても速度が変わらない?ローカルLLMのボトルネックの正体
自分のPCで生成AI(ローカルLLM)を動かす際、CPUのコア数やスレッド数が多ければ多いほど速くなると思われがちです。しかし、実験の結果、スレッド数を半分に絞っても速度にほとんど変化がないことが分かりました。なぜこのような現象が起きるのか、その理由を探ります。
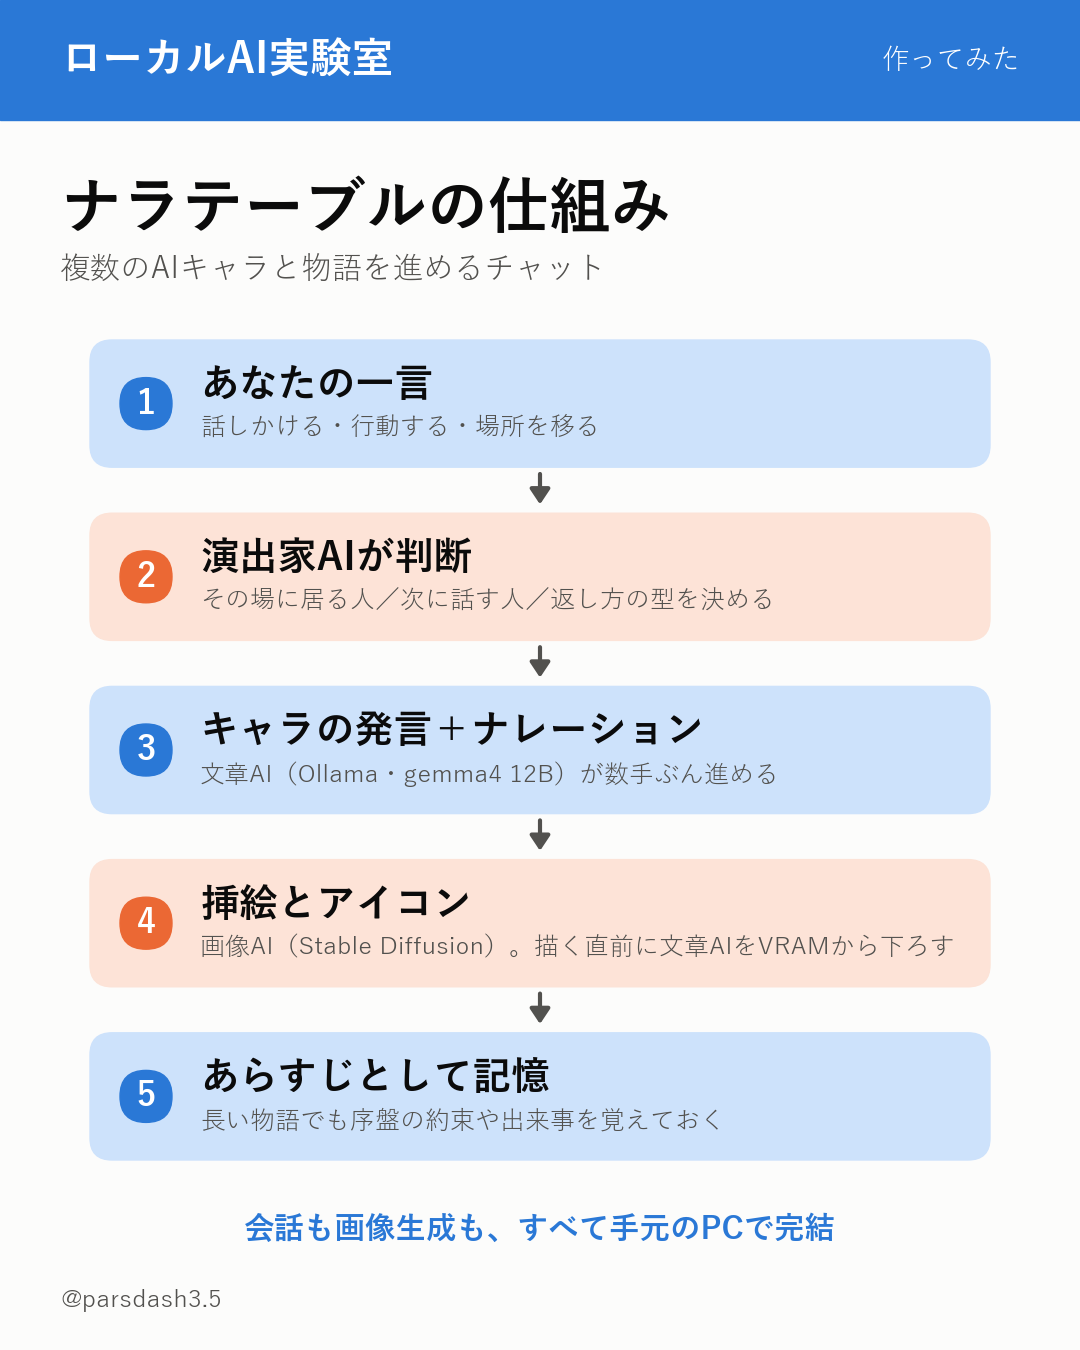
物語を動かすのは「演出家」の役割。ローカルAIで自然な会話を実現する仕組み
このアカウントの運営者が実際に使用しているツール『ナラテーブル』の裏側にある、AIによる場面進行の仕組みについて詳しく解説します。
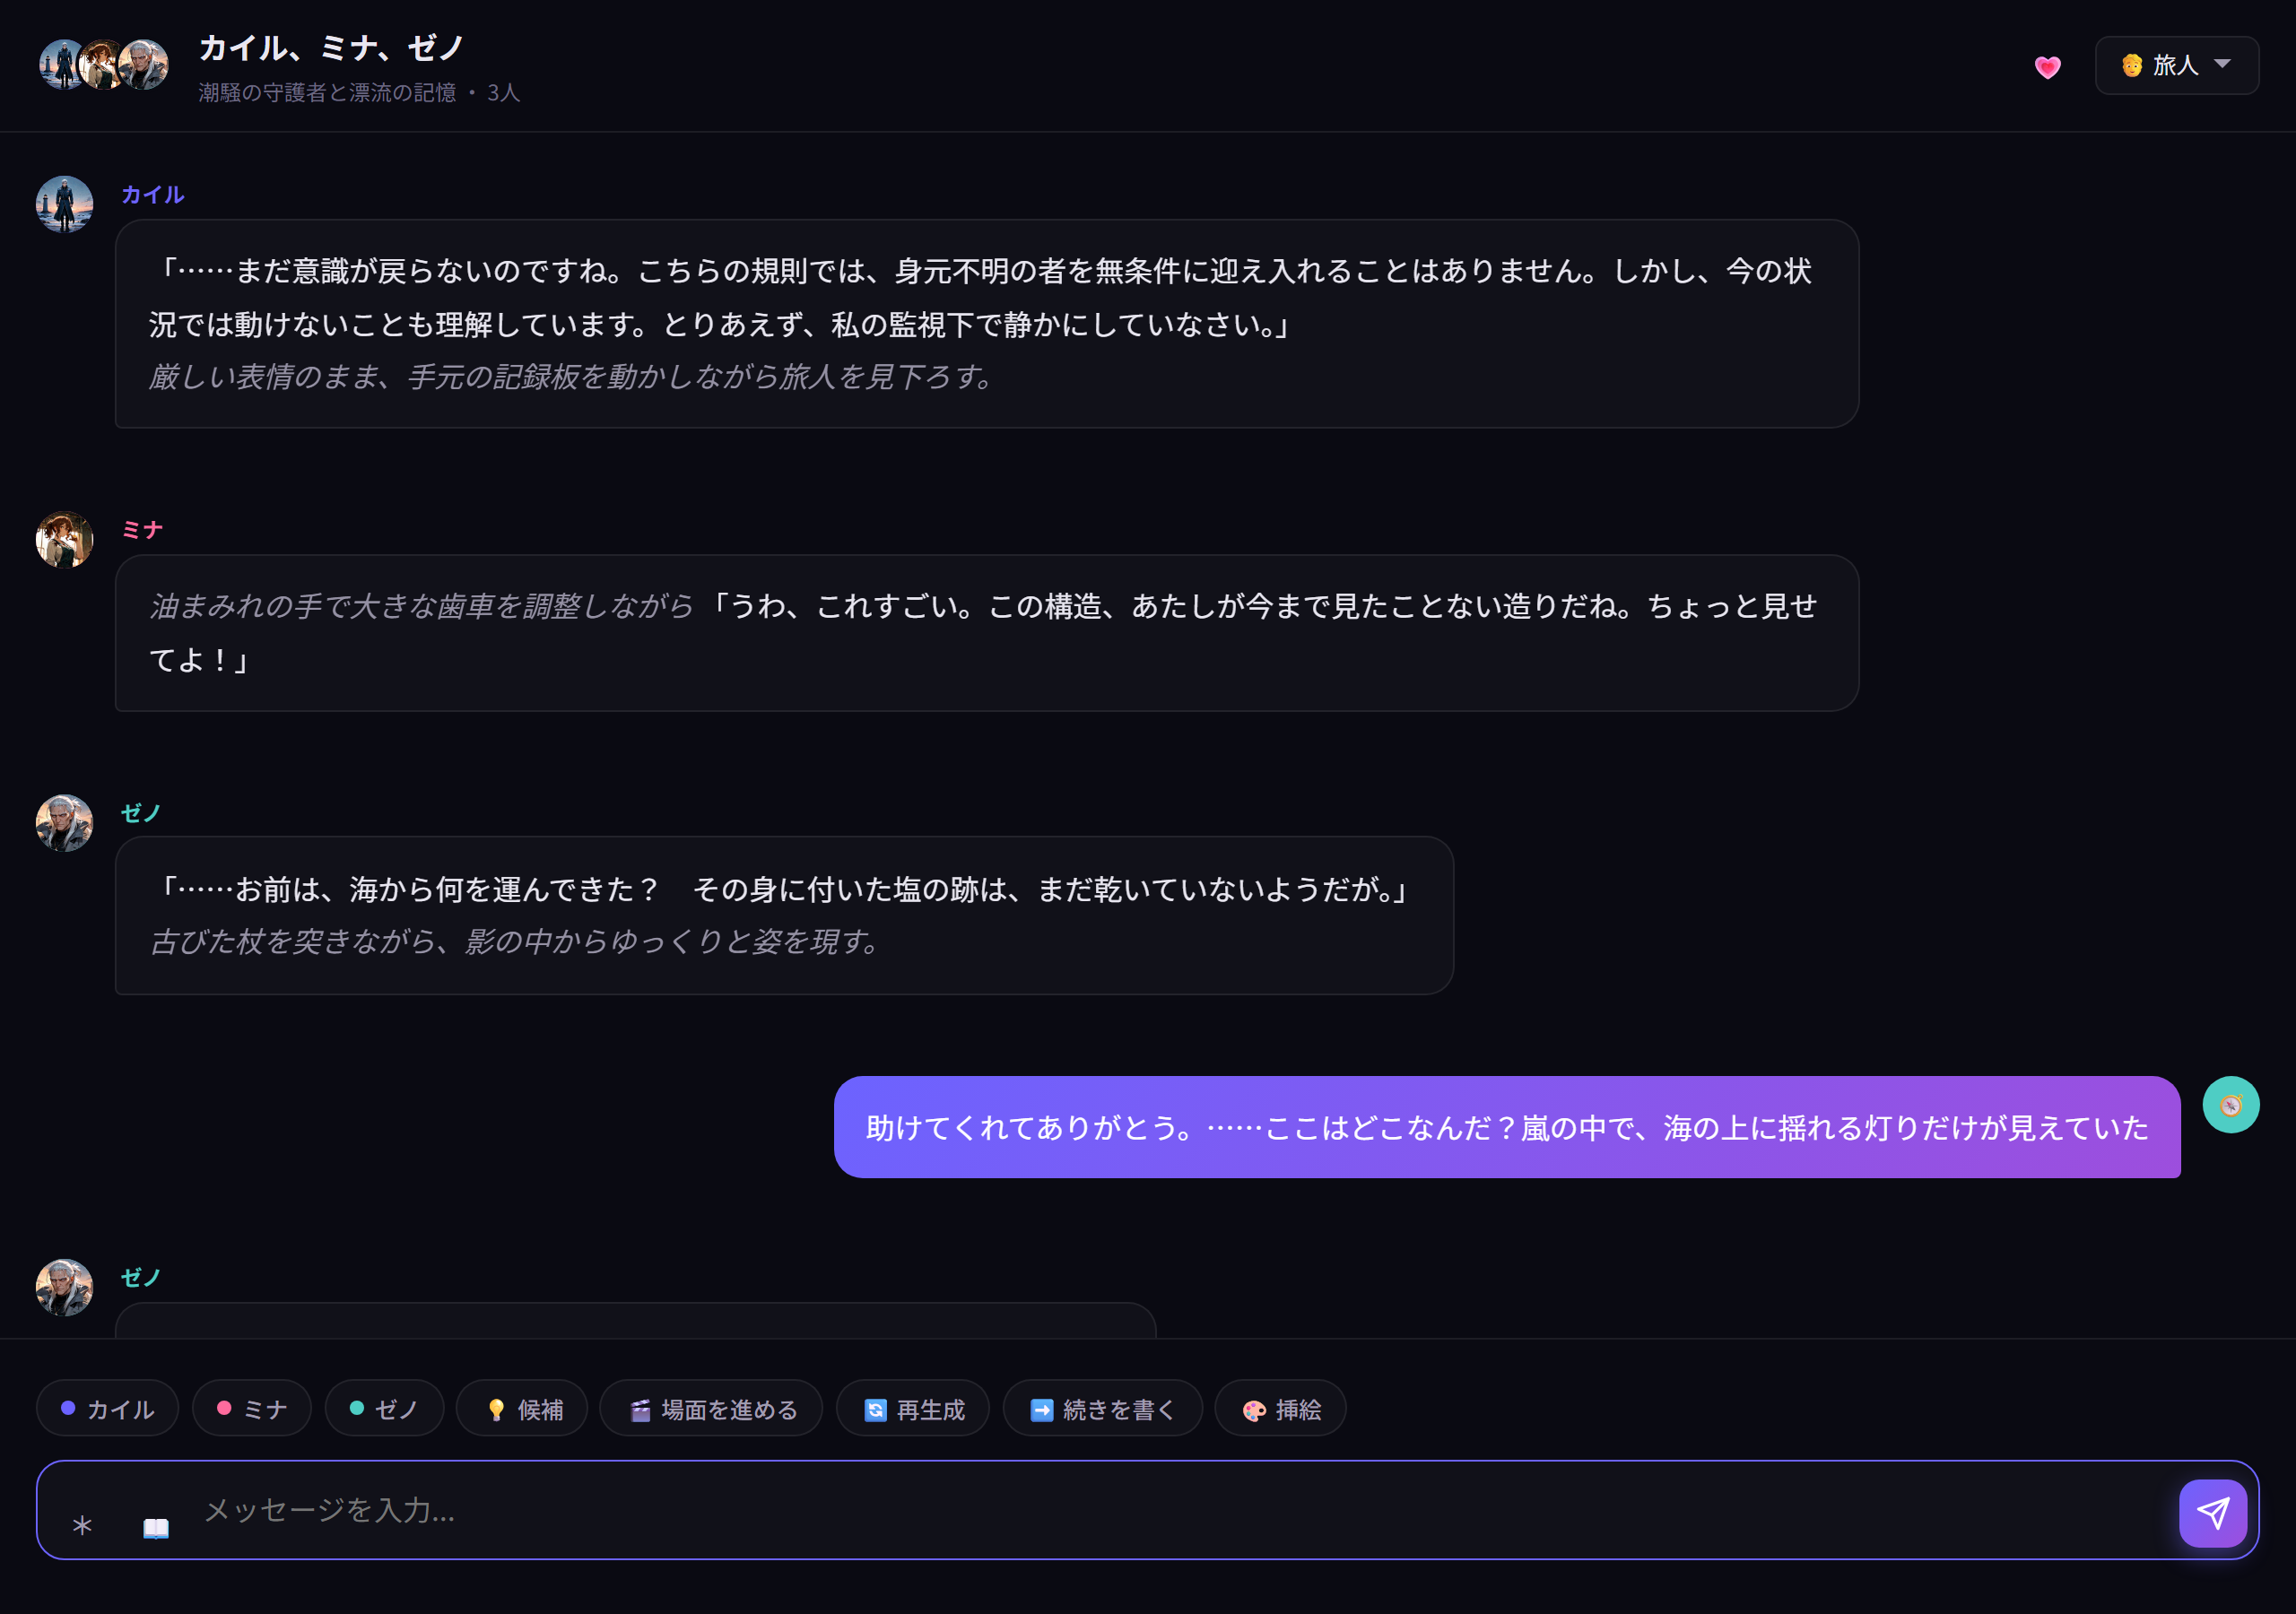
【完全ローカル】AIキャラクターたちと物語を紡ぐ「ナラテーブル」を自作してみた
ネット環境に依存せず、自分のPC内で完結する多人数ロールプレイチャットの構築事例を紹介します。
ローカルAIを最も手軽に始めるための第一歩:Ollamaの活用法
自分のPC上でAIを動かす「ローカルAI」の世界へ入るための、最もシンプルな入り口であるOllamaについて解説します。
自分のPCでAIを動かす最大の利点は「安心感」と「自由度」
ローカルAIを導入する際の大きなメリットである機密情報の保護や、具体的な活用事例について解説します。
AIに長い資料を読み込ませる際の注意点:コンテキスト長とメモリの関係
ローカル環境でAIを動かす際に重要となる「コンテキスト長」の仕組みと、PCのメモリ消費との関係について解説します。
ローカルAIの選び方の基本:モデル名の「B」という数字の意味と速度の関係
ローカル環境でAIを動かそうとした際、最初に出会うのが「4B」や「9B」といったモデル名です。この記事では、これらの数字が何を意味するのか、そして自分のPCスペックに合わせてどのようにモデルを選べばよいのかを詳しく解説します。
ローカルAIを動かす鍵は「VRAM」の容量にあり!GPUメモリと速度の関係を解説
ローカル環境でAIを快適に動かしたいと考えている方にとって、最も重要なスペックの一つが「VRAM(ビデオメモリ)」です。なぜVRAMが重要なのか、実際にモデルを動かした際の劇的な速度差を交えて詳しく解説します。
条件に合う記事がありません。
実測データ(抜粋)
すべて見る →| モデル | 使用メモリ | GPUあり | 体感 | CPUのみ | 体感 | 測定日 |
|---|---|---|---|---|---|---|
| gemma3:1b | 0.9 GB | 216.9 | 一瞬 | 61.7 | 一瞬 | 2026-10-04 |
| llama3.2:3b | 2.3 GB | 189.7 | 一瞬 | 27.3 | 快適 | 2026-10-04 |
| qwen3.5:2b | 2.3 GB | 170.4 | 一瞬 | 27.7 | 快適 | 2026-10-04 |
| gemma3:4b | 2.8 GB | 142.0 | 一瞬 | 21.5 | 快適 | 2026-10-04 |
| qwen3.5:4b | 3.1 GB | 132.1 | 一瞬 | 19.3 | 快適 | 2026-10-04 |
数字は「1秒あたりに書けるトークン数」。実測のやり方と体感の目安 →