自分専用のAIを育てる。知識922件の蓄積とRAGによる情報の自動抽出
「自分専用のAIを育てる」という試みを始めました。この実験の目的は、膨大な情報の中から必要な知識を瞬時に引き出せる環境を構築することです。本記事では、実験開始から10日目で蓄積された922件の知識と、その裏側にある仕組みについて詳しく解説します。
- RAG(検索拡張生成)という仕組みを用いて、意味で検索可能な形に情報を蓄積
- 収集する情報はニュースの見出しや、自身の過去の投稿・実測データ
- PCのCPUを活用することで、執筆用のGPU資源を温存した運用を実現
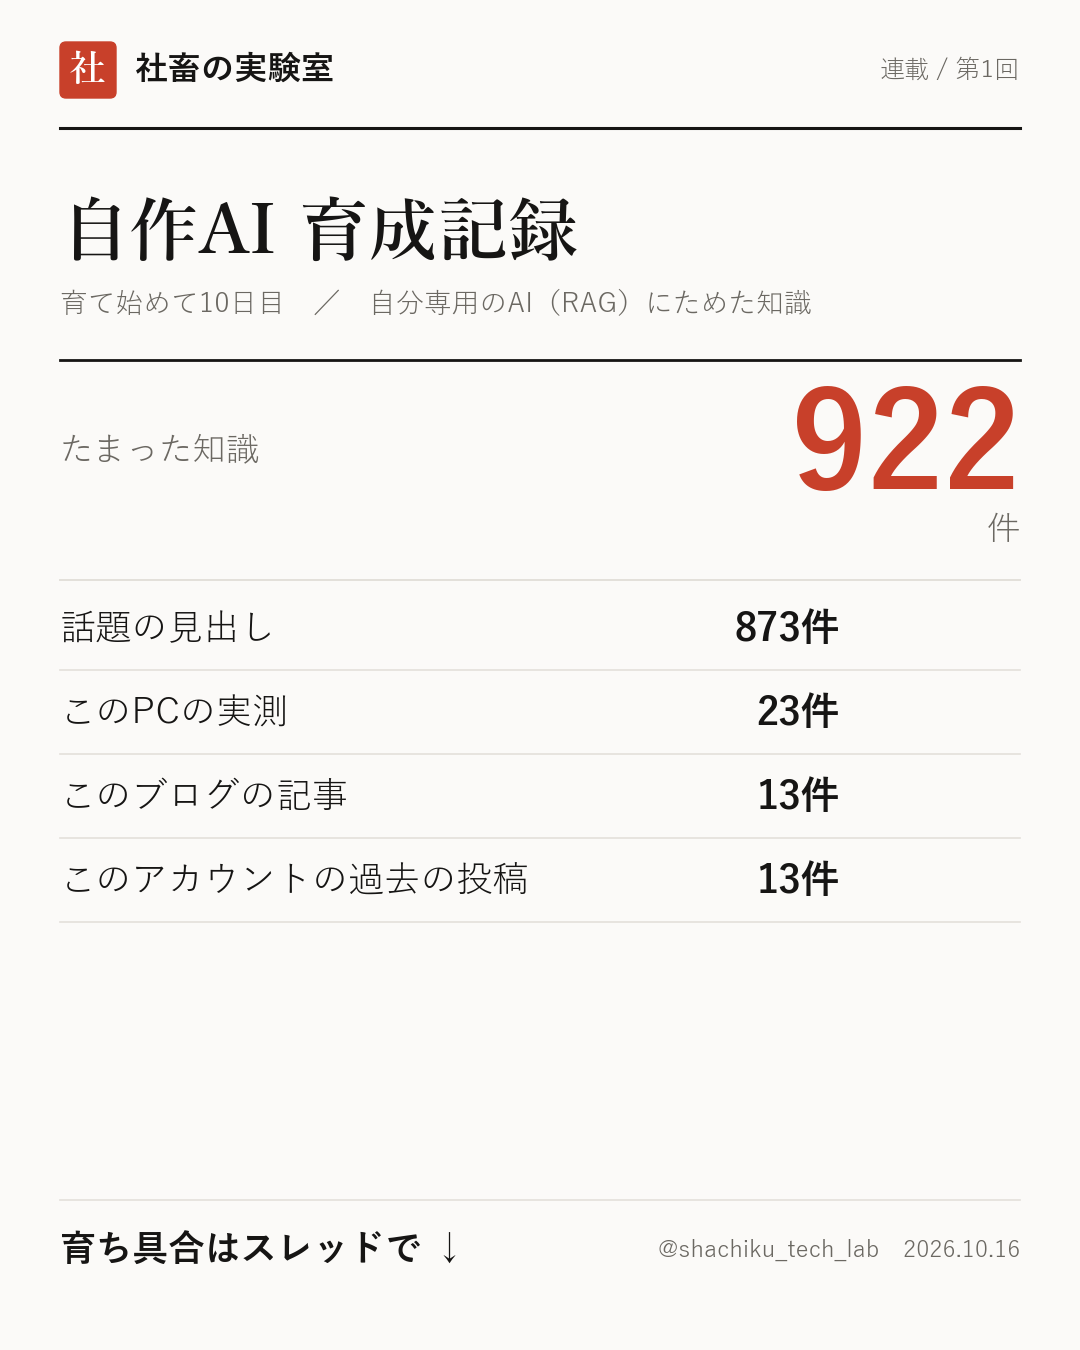
実験の概要と現在の進捗
本実験は、2026年10月6日に開始されました。公開時点で現在、蓄積された知識の総数は922件に達しています。開始時点では164件であったため、わずか10日間で大幅な増加を見せました。
蓄積している知識の内訳は以下の通りです。
・話題の見出し:873件
・このPCの実測データ:23件
・このアカウントの過去の投稿:13件
・本ブログの記事:13件
このように、外部のトレンド情報と自分自身の固有データを組み合わせて蓄積していくのが特徴です。
情報の収集方法と「RAG」の仕組み
今回の実験では、note、Zenn、Qiita、はてなブックマークなどで話題になっているAIに関する記事から、毎日見出しを収集しています。ここで重要なのは、他人の記事本文を保存するのではなく、見出しと短い要約、そしてリンクだけを保存している点です。
これらの情報を「意味で探せる形」に変換して蓄積するのが、今回のシステムの中核である「RAG(検索拡張生成)」という仕組みです。RAGとは、AIが回答を生成する際に、外部の知識ベースから関連する情報を探し出し、それを踏まえて回答を構成する手法のことです。
この「意味で探す」ための処理には、bge-m3という埋め込みモデル(文章を数値化して、意味の近さを計算する技術)を使用しています。また、システムの動作はPCのCPUのみで行っています。これは、文章を生成するAIの処理にGPU(画像や高度な計算を得意とするプロセッサ)を優先的に割り当てるための工夫です。
参考:モデルの大きさと速さ(実測)
実際の動作検証:キーワードからの抽出
実際にシステムがどのように機能するかを確認するため、「ChatGPT」という言葉で知識の引き出しを試行しました。その結果、関連性の高い以下の見出しが自動的に最大6件まで抽出されました。
・仕事で今日から使えるChatGPTプロンプト3選|メール・議事録・文章修正がラク
・ゲーム開発、ChatGPTの「のぞき見」に注意
・ChatGPT基本編:登録・料金・使い方
このように、単なるキーワードの一致だけでなく、内容の意味を汲み取って関連する情報を提示できることが確認できました。
直近のトレンドと今後の展望
この2週間で特に多く集まったキーワードは、ChatGPT(22件)、Claude Code(21件)、エージェント(18件)、Claude(14件)、ローカルLLM(14件)といった項目でした。これらは現在のAI分野における主要な関心事といえます。
次回は2週間後の第2回として、知識の蓄積量がさらに増えた際に、引き出される情報の精度や内容がどのように変化するかを報告します。知識が増えることで、より精度の高い情報抽出が可能になるか、その推移に注目が集まります。
- 自分だけの知識ベースを作りたい方
- RAGの仕組みに興味がある方
- 最新のAI動向を効率的に収集したい方
- すぐに高度なプログラミングができることを期待する方
- 一瞬で完璧な回答が得られる魔法のようなツールを探している方
よくある質問
Q. なぜ本文を保存しないのですか?
公式の情報に基づくと、他人の記事の全文を保存することは権利の観点から避け、見出しと要約のみを蓄積する方針をとっています。
Q. CPUだけで動かすメリットは何ですか?
文章を書くためのAI処理にGPUのパワーを集中させるためです。検索処理(RAG)の一部をCPUに任せることで、全体の動作効率を最適化しています。
本記事では、自分専用の知識ベースを構築するための「自作AI育成」の第一歩を紹介しました。RAGという仕組みを使い、ニュースの見出しや自身のデータを毎日蓄積することで、必要な時にだけ関連情報を引き出せる環境を作っています。現在は922件の知識を蓄積しており、今後はこの蓄積量が情報の精度にどう影響するかに注目していきます。
続きはThreadsで。新しいAIの実測と、仕事で使えた使い方を毎日投稿しています。
@shachiku_tech_lab をフォロー関連記事
【解説】AIだけでキャラのボイスと衣装を完全自作する仕組み
「AI麻雀道場」の第3回で公開した、AIを活用したキャラクター制作の裏側を詳しく解説します。自分のPC(ローカル環境)だけで完結させるためのポイントをまとめました。
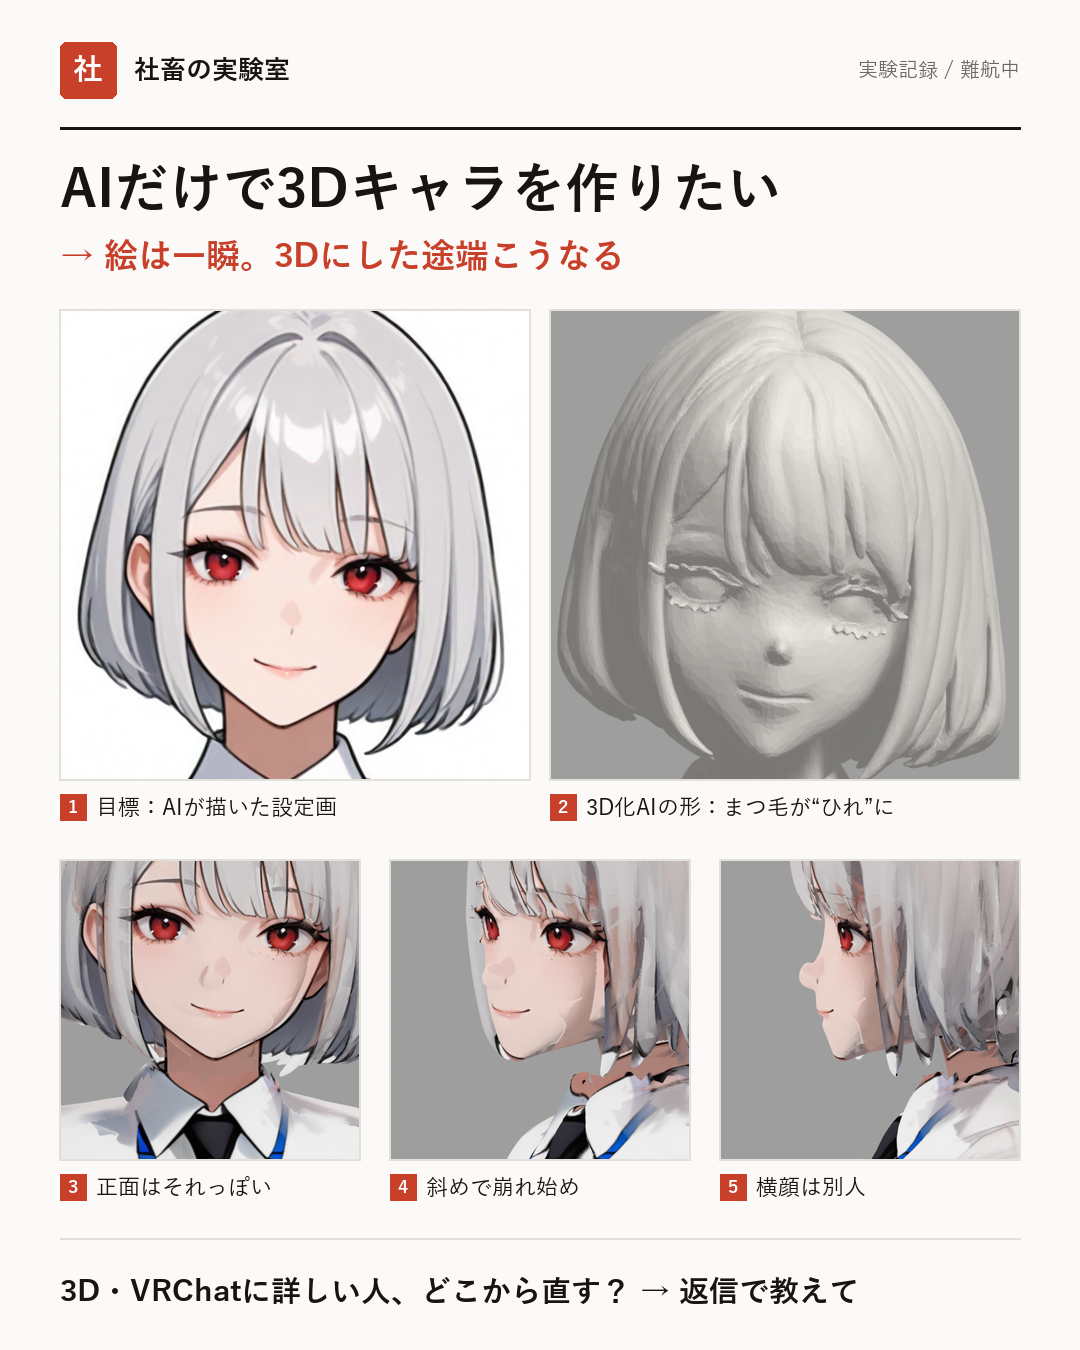
画像から3DキャラをAIで作る|Hunyuan3D-2.1でVRChatアバターに挑戦した失敗と対策
画像生成AIで描いた設定画を Hunyuan3D-2.1 で3Dモデルにし、VRChat アバターを目指す挑戦の記録。横顔が崩れる理由、3D化AIのあるある失敗6つ、自動リギング(SkinTokens)の結果、次の作戦をまとめました。
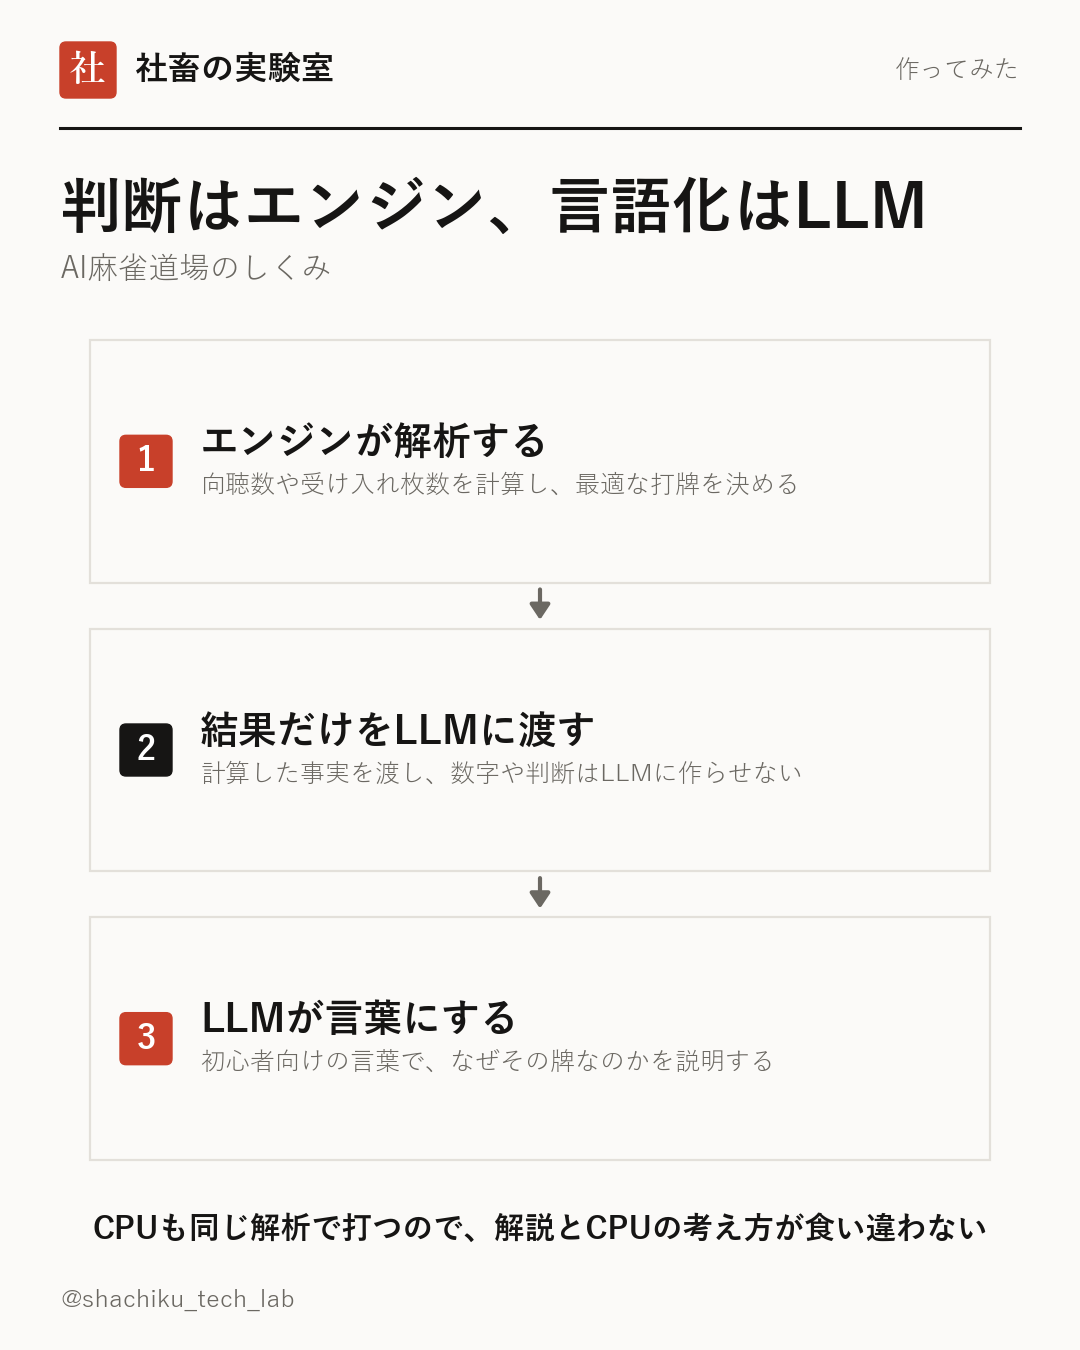
AI麻雀道場 第2回:判断はエンジン、言語化はLLM
ローカルAIを活用して麻雀を学ぶツール「AI麻雀道場」の開発秘話。なぜLLMにすべてを任せてはいけないのか、正確な解説を実現するための「役割分担」の仕組みについて詳しく解説します。
新しいモデルの実測や解説を毎日投稿しています
Threadsでフォロー以上、本日の業務日報でした。