【自作AI育成日記 第3回】わずか38日で知識ベースが1万件を突破した過程と仕組み
こんにちは、シャチラボです。今回は、現在進めている「自分専用のAIを育てるプロジェクト」の進捗をお届けします。活動を開始してからわずか38日という短期間で、AIが参照する知識の数が1万件を超えました。どのような仕組みでこの知識を蓄積し、活用しているのか、その舞台裏を詳しく解説します。
- 知識の蓄積状況:話題のAI記事の見出しを中心に、多様なデータを統合
- 仕組みの解説:RAG(検索拡張生成)を用いて「意味で探せる形」で管理
- リソースの最適化:CPUを活用した効率的な処理と、文章生成へのGPUの温存
- 最新のトレンド:蓄積されたデータから見える、今注目されているキーワード
知識ベースの現在の状況
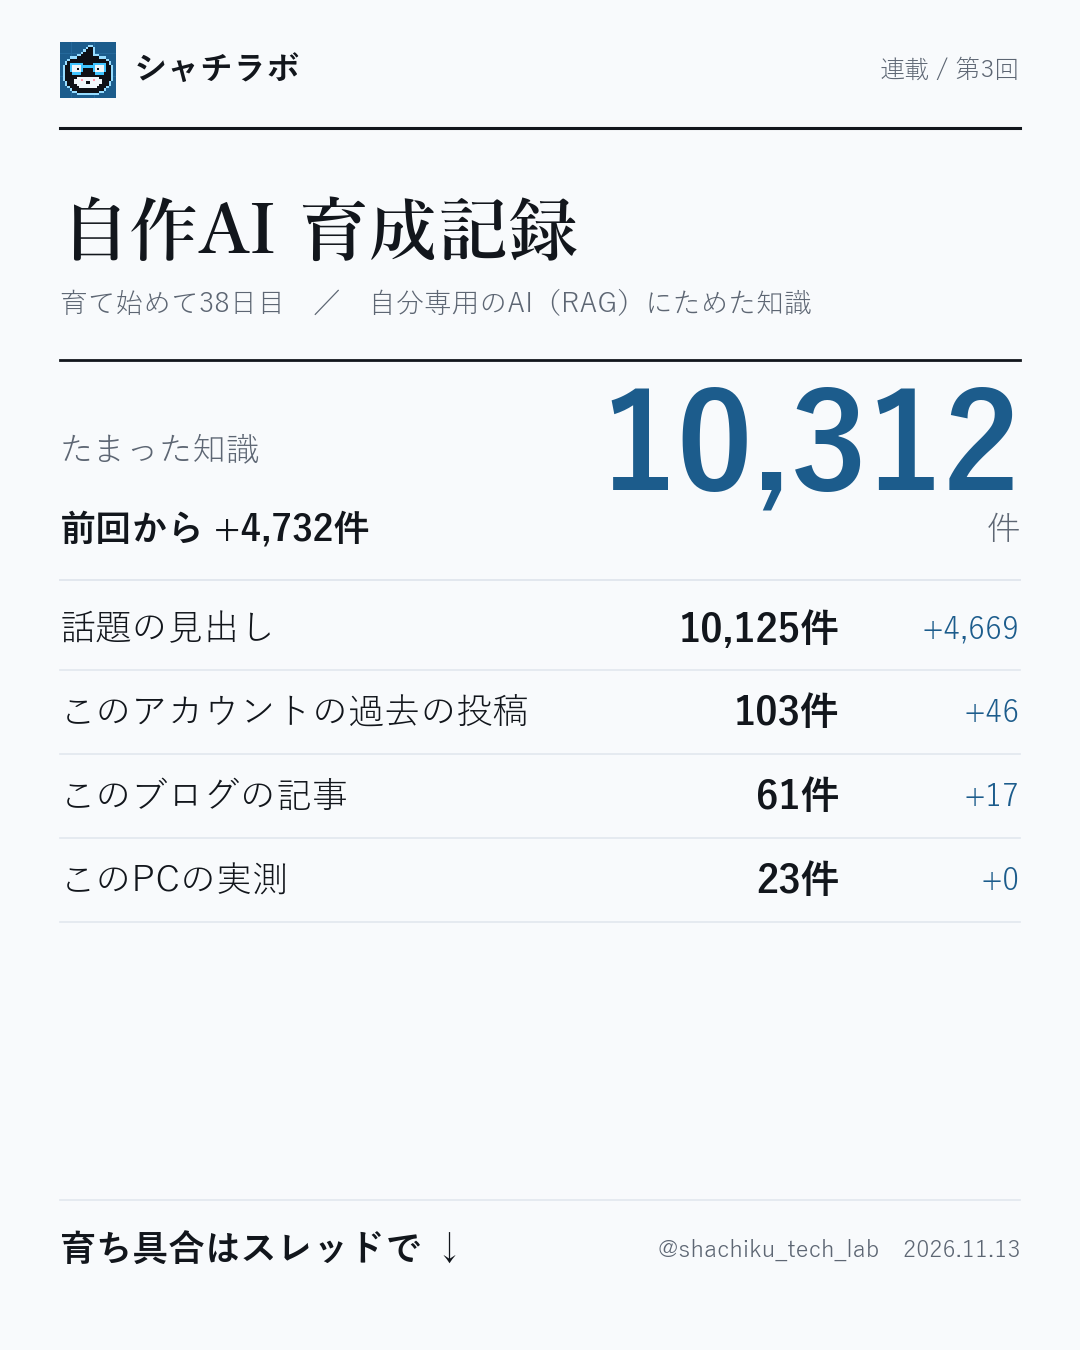
プロジェクトを開始して38日目、蓄積された知識の総数は10312件に達しました。前回(第2回)の時点では5580件であったため、この期間だけで4732件もの知識が追加されたことになります。
現在蓄積されているデータの内訳は以下の通りです。
・話題の見出し:10125件(note、Zenn、Qiita、はてなブックマークで話題のAI記事から抽出)
・このアカウントの過去の投稿:103件
・このブログの記事:61件
・このPCの実測データ:23件
このように、外部のトレンド情報と自分自身の過去の活動データを組み合わせることで、多角的な知識ベースを構築しています。
- 外部情報の取り扱い:他者の記事については、著作権や情報の正確性を考慮し、本文は保存せず「見出し」「短い要約」「リンク」のみを蓄積しています。
知識を「意味で探せる形」にする仕組み
このプロジェクトの核心は、単にデータを溜めることではなく、AIが「意味」で内容を検索できるようにすることにあります。この仕組みをRAG(Retrieval-Augmented Generation:検索拡張生成)と呼びます。RAGとは、AIが回答を生成する際に、あらかじめ用意した外部知識から関連する情報を探し出し、それを踏まえて回答を作る仕組みのことです。
今回のシステムでは、意味で探すための「埋め込みモデル」として『bge-m3』を採用しています。これにより、キーワードの一致だけでなく、文脈や意味の近さに基づいて情報を抽出することが可能になります。
実際の運用では、ブログの投稿を書く際に、そのテーマに関連する知識を最大6件まで自動で引き出し、AIに提示するようにしています。これにより、AIはより正確で、自分の過去のデータに基づいた回答を生成できるようになります。
- 処理の工夫:知識の検索(埋め込み)処理はPCのCPUだけで実行しています。これにより、文章を生成するAI処理に必要なGPU(画像処理や高度な計算を得意とする演算装置)の負荷を抑え、効率的な動作を実現しています。
参考:モデルの大きさと速さ(実測)
データから見える最新のトレンド
蓄積されたデータの中から、この2週間で特によく話題に挙がっていたキーワードを抽出しました。現在、AIの分野では以下の言葉が注目されていることが分かります。
・Claude(61件)
・Claude Code(57件)
・エージェント(55件)
・ChatGPT(50件)
・ローカルLLM(40件)
(※ローカルLLM:自分のPCなどのローカル環境で動作させる大規模言語モデルのこと)
実際に「Claude」というキーワードで知識を引き出したところ、仕事での使い方や、特定の運用に関する見出しなどが上位に挙らりました。知識が増えることで、より意図に近い情報を正確に引き出せるようになっていることが確認できます。
- 今後の展望:知識がさらに積み重なることで、AIが引き出す情報の精度や多様性がどのように変化していくのか、次回の報告(第4回)で詳しくお伝えします。
- 自作AIの構築に興味がある方
- RAGの仕組みを具体例で知りたい方
- AIの最新トレンドをデータで確認したい方
- 最新の高度なプログラミング技術をすぐに習得したい方
- 具体的なソースコードの実装方法を詳しく知りたい方
よくある質問
Q. なぜ本文は保存しないのですか?
他者の記事であるため、著作権への配慮から、見出しと要約、そしてリンクのみを蓄積する方針をとっています。
Q. なぜCPUだけで動かしているのですか?
文章を生成するAIの処理にGPUを集中させるため、検索処理(埋め込み)はCPUで効率的に行う構成にしています。
本記事では、わずか38日で知識ベースを1万件以上に拡大させた「自作AI育成日記」の第3回をお届けしました。RAGという仕組みを使い、毎日集まるAIのトレンド記事を見出しと要約で蓄積。CPUを活用した効率的なシステム構成によって、自分専用の知識をAIに学習させている過程を詳しく解説しています。
続きはThreadsで。新しいAIの実測と、仕事で使えた使い方を毎日投稿しています。
@shachiku_tech_lab をフォロー関連記事
AIにメールの下書きを任せる際に「手直し」を減らすための5つのコツ
AIにメールの下書きを依頼する際、やりがちな「丁寧すぎて長すぎる」「意図と違う」といった問題を解決するための具体的な指示の出し方と、運用上の注意点を詳しく解説します。
画像が増えても重くならない!ギャラリー表示を劇的に高速化する最適化の技術
「画像が増えるほど動作が重くなる」という、Web制作やアプリ開発でよくある課題を、実際に「カベガミ工房」の最適化を通じて解決した事例を解説します。ブラウザのメモリ管理やデータ処理の効率化について、初心者の方にも分かりやすく紐解きます。
AIへの指示を劇的に変える「4つの要素」と改善のコツ
AIへの指示(プロンプト)の精度を上げるための基本的なフレームワークと、効率的なやり取りの方法について詳しく解説します。
新しいモデルの実測や解説を毎日投稿しています
Threadsでフォロー以上、今日の実験ログでした。