AIモデルの名称「30b-a3b」に隠された仕組みとメリットを解説
AIモデルを比較する際、名称の中に「30b-a3b」といった複雑な数字が含まれていることがあります。これらは一見すると難解ですが、実はそのAIが「どれくらい賢いか」と「どれくらい速く動くか」という特性を非常に分かりやすく表しています。今回は、この数字の正体であるMoE(Mixture of Experts)という仕組みについて詳しく解説します。
- 30bはモデルの全体的な知識量を表す
- a3bは一度の計算で動く処理の軽さを表す
- MoE(Mixture of Experts)によって、賢さと速さを両立している
- ファイルサイズはモデル全体を保持するため、メモリ容量には注意が必要
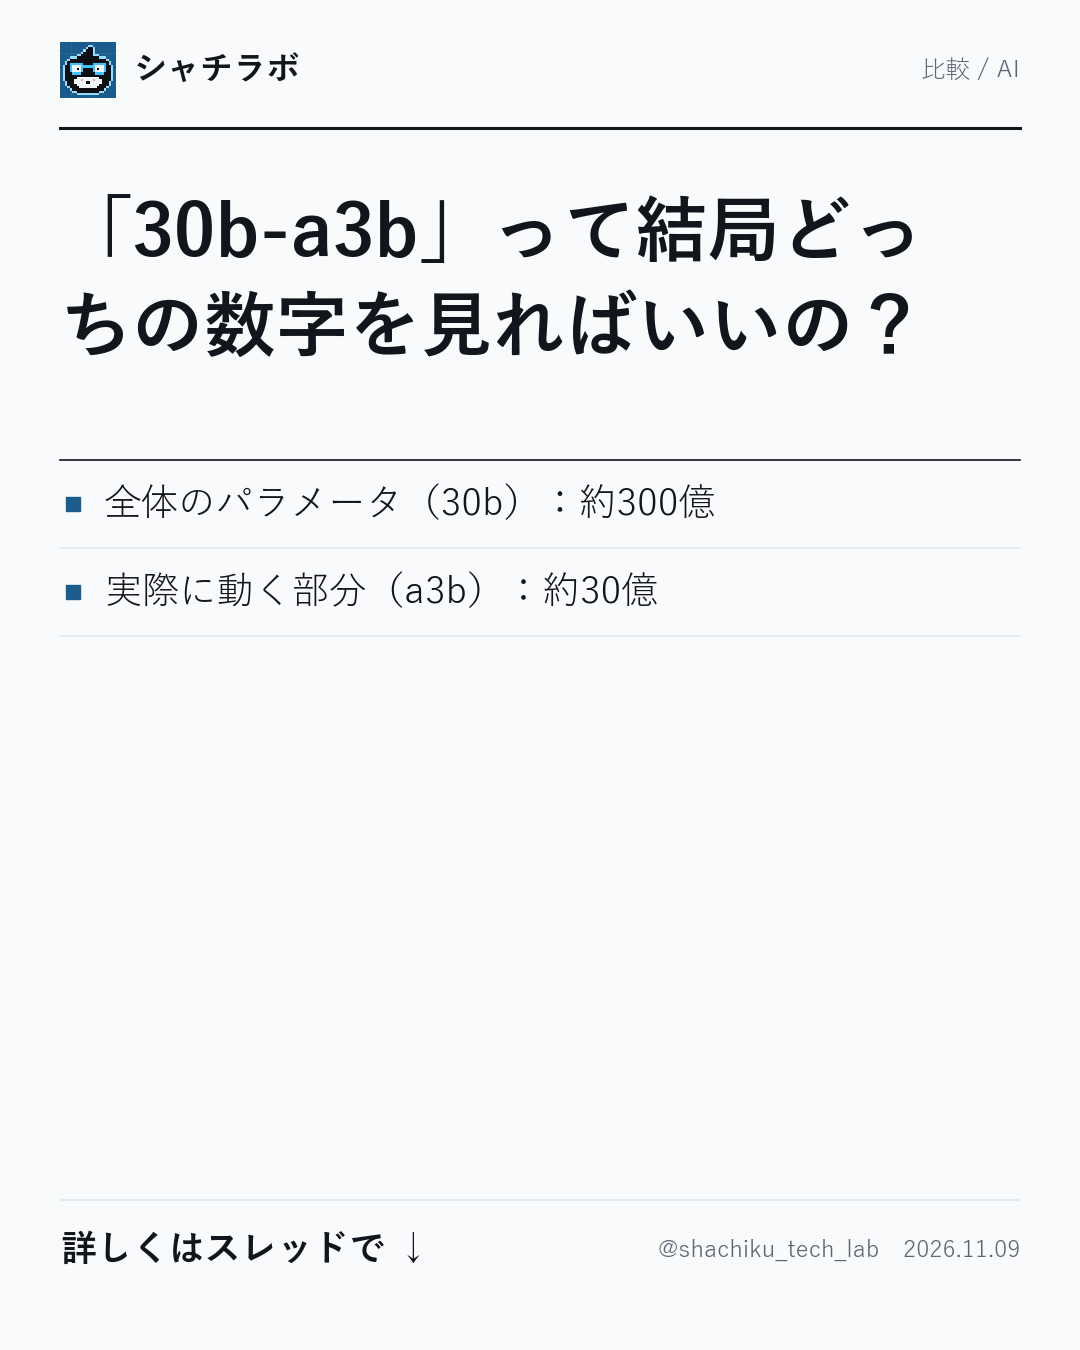
モデル名の数字が示す「知能」と「速さ」
AIモデルの名称にある「30b」という数字は、モデル全体のパラメータ(AIが学習した情報の断片や、知識の構成要素のこと)の総量を示しています。今回の例で言えば、約300億のパラメータを持っていることを意味します。
この数字は、AIがどれだけ幅広い知識を蓄えているか、つまり「知能の総量」を反映していると考えられます。一般的に、この数字が大きいほど、より複雑な事柄を理解したり、高度な推論を行ったりできる可能性が高まります。
一方で、その隣にある「a3b」という数字は、AIが実際に動作する際に、一度の計算で動かすパラメータの量を指しています。これは約30億のパラメータが動くことを意味します。この数字は、AIの「処理の軽さ」や「動作の速さ」に直結する要素です。
- 30b:AIの「知能の総量」を表す指標
- a3b:1回の計算で動く「処理の軽さ」を表す指標
MoE(Mixture of Experts)という仕組み
なぜ、全体が大きくても(30b)、動く部分を小さく(a3b)できるのでしょうか。その鍵を握るのが「MoE(Mixture of Experts)」という仕組みです。
MoEとは、モデルの中に複数の「専門家(Experts)」を用意しておき、入力された内容に応じて必要な専門家だけを呼び出して動かす仕組みのことです。例えば、数学の問題であれば数学の専門家を、文章の要約であれば要約の専門家を動かすといったイメージです。
この仕組みの最大のメリットは、モデル全体を動かすよりも圧倒的に少ない計算資源で処理を完結できる点にあります。これにより、大きな知識量(高い知能)を持ちながら、実際の動作は小さなモデルに近いスピードで実行することが可能になります。
- 全体を動かさず、必要な専門家だけを呼び出す
- 「賢い」ことと「速い」ことを高いレベルで両立させる技術
参考:モデルの大きさと速さ(実測)
利用する際の注意点:メモリの確保
MoEという仕組みは非常に効率的ですが、利用する際には注意すべき重要なポイントがあります。それは「ファイルサイズ」と「メモリ容量」の関係です。
「動く部分(a3b)」が小さいからといって、モデルのファイルサイズ自体が小さくなるわけではありません。AIを動かすためには、モデルの知識すべてが含まれている「全体(30b)」のデータを読み込む必要があるため、それに見合ったメモリ(VRAM等)が必要です。
公式の情報では、モデル全体を置くためのメモリが必要であるとされています。したがって、実際の動作が速いからといって、動作環境の負荷がすべて低いと判断するのは誤りです。自分の環境で動作させるためには、モデル全体のパラメータ数に耐えられるメモリ容量を備えているかを確認することが大切です。
- 動作が軽いことと、ファイルサイズが小さいことは別である
- モデル全体を読み込むためのメモリ容量を事前に確認すること
まとめ
モデル名の「30b-a3b」という数字は、そのAIが「300億規模の知識量を持ちつつ、30億規模の軽さで計算を行う」という特徴を教えてくれています。
MoEという仕組みのおかげで、私たちは高度な知能をよりスムーズなレスポンスで享受できるようになっています。AIを選ぶ際は、この「賢さ」と「速さ」のバランスを理解した上で、自分の環境に適したモデルを見極めていきましょう。
- 30bは知識の広さ、a3bは動作の軽さを意味する
- MoEによって知能と速度の両立を実現している
- メモリ容量はモデル全体のサイズに依存することを忘れない
- AIモデルの名称の意味を知りたい初心者の方
- MoEという仕組みに興味がある方
- AIを自分のPCなどで動かそうと考えている方
- 高度な数学的アルゴリズムの内部実装を詳しく知りたい専門家
よくある質問
Q. a3bの数字が小さいほど、AIは賢くなるのですか?
いいえ、a3bは「一度に動く部分」の小ささを表すため、この数字が小さいほど動作は軽くなります(速くなります)。AIの賢さは、基本的には「30b」のような全体のパラメータ数に依存します。
Q. メモリが足りない場合はどうすればいいですか?
モデル全体のパラメータ数が小さいものを選ぶか、より大きなメモリ容量を持つハードウェアを用意する必要があります。動作の軽さ(a3b)に関わらず、モデル全体のデータはメモリ上に展開される必要があるためです。
続きはThreadsで。新しいAIの実測と、仕事で使えた使い方を毎日投稿しています。
@shachiku_tech_lab をフォロー関連記事
AIサービスの有料版と無料版、仕事でどう使い分ける?失敗しないための判断基準
AIを仕事に取り入れたいけれど、いきなり有料プランに入るべきか迷っている方へ。無料版でまず「体験」することの重要性と、有料版に移行する際の主なチェックポイントを解説します。
CPUのスレッド数を減らしてもAIの生成速度が変わらない理由について
AIモデルを自分のPCで動かす際、CPUのスレッド数を調整することで速度が変わるのか、実測データをもとに解説します。
ローカルAIのモデル名にある「Q4」「Q8」の意味とは?量子化の仕組みを分かりやすく解説
AIモデルの名称によく見られる「Q4」や「Q8」という表記。これらはAIを軽量化するための「量子化」という技術に関係しています。初心者の方向けに、それぞれの違いや選び方の基準を解説します。
新しいモデルの実測や解説を毎日投稿しています
Threadsでフォロー以上、今日の実験ログでした。