
「ローカルAI」の記事
AIサービスの有料版と無料版、仕事でどう使い分ける?失敗しないための判断基準
AIを仕事に取り入れたいけれど、いきなり有料プランに入るべきか迷っている方へ。無料版でまず「体験」することの重要性と、有料版に移行する際の主なチェックポイントを解説します。
CPUのスレッド数を減らしてもAIの生成速度が変わらない理由について
AIモデルを自分のPCで動かす際、CPUのスレッド数を調整することで速度が変わるのか、実測データをもとに解説します。
ローカルAIのモデル名にある「Q4」「Q8」の意味とは?量子化の仕組みを分かりやすく解説
AIモデルの名称によく見られる「Q4」や「Q8」という表記。これらはAIを軽量化するための「量子化」という技術に関係しています。初心者の方向けに、それぞれの違いや選び方の基準を解説します。
【実測データ公開】GPUなしのPCでもローカルAIを快適に動かすためのモデル選び
「自分のPCにはグラフィックボード(GPU)が入っていないから、ローカルAIは諦めるしかない」と考えていませんか?実は、モデルのサイズを適切に選ぶことで、CPUのみの環境でも十分に実用的な速度でAIを動かすことが可能です。本記事では、実測データに基づいた「GPUなしで動かすための条件」を詳しく解説します。
Claude Codeで動画編集を自動化?8時間の素材を30分で処理した検証結果
AIツール「Claude Code」を用いて、膨大な動画素材をいかに効率よく編集できるかを検証した結果を詳しく解説します。
メモリ8GBのPCでもローカルAIは動く?実測データから判明した「ちょうどいい」モデルの選び方
「自分のPCのスペックでは動かないかも」と諦めていた方へ。メモリ8GBの環境でも、モデルの選び方次第でローカルAIを快適に活用できることを実測データをもとに解説します。
AIモデルの名称「30b-a3b」に隠された仕組みとメリットを解説
AIモデルの名称に含まれる数字が何を意味するのか、初心者の方にも分かりやすく解説します。
AIの回答を「決まった形」で受け取る方法:JSONスキーマの活用
ローカルAIを活用する際に、AIの回答をプログラムで扱いやすい形式に固定するための手法について解説します。
メモリ8GBのPCでもローカルAIは動く?実測データから判明した「ちょうどいい」モデルの選び方
「自分のPCのスペックでは、AIを動かすのは無理だろう」と諦めていませんか?実は、メモリが8GBであっても、モデル(AIの脳にあたるデータ)のサイズを適切に選べば、驚くほどスムーズに動かすことが可能です。今回は、実際にメモリ8GBの環境で複数のモデルを動かした実測データをもとに、初心者の方でも安心して試せる「ちょうどいいサイズ」を解説します。
ClineのPlanモードとActモードを使い分ける!Claude Codeのような開発体験を再現する方法
Claude Codeの計画モードに近い操作感を、ClineとローカルLLMの組み合わせで実現する手順を解説します。
メモリ2GB未満でも動作?低スペックPCで動くリアルタイム文字起こしツール「hayamimi」の衝撃
「自分のPCではスペック不足でAIは動かせない」と諦めていた方に朗報です。今回は、驚くほど低いハードウェア要求で動作するリアルタイム文字起こしツール「hayamimi」について、公式情報を基に詳しく解説します。
AIが提案したExcel関数でエラーが出る時の対処法:正確な回答を引き出すためのコツ
AIにExcelの相談をするとき、期待した通りに動かずエラーが出てしまうことは珍しくありません。しかし、指示の出し方(プロンプト)を少し工夫するだけで、AIから正しい回答を引き出すことは十分に可能です。本記事では、AIから正確な関数を引き出すための具体的な改善ポイントを解説します。
メモリ8GBのPCでローカルAIを動かすための実践ガイド:実測データに基づくモデル選び
メモリ容量に制約がある環境で、いかに実用的な速度でローカルAIを動作させるか。実測データに基づいた最適なモデル選びのポイントを解説します。
AIの反応が遅い原因はVRAM不足かも?実測でわかった速度差の正体
自分のPCでAIを動かす際に「なぜか反応が遅い」と感じる原因として多いのが、GPUのメモリ(VRAM)容量の問題です。本記事では、モデルがVRAMに収まっているかどうかが速度にどのような影響を与えるのか、実測データをもとに詳しく解説します。
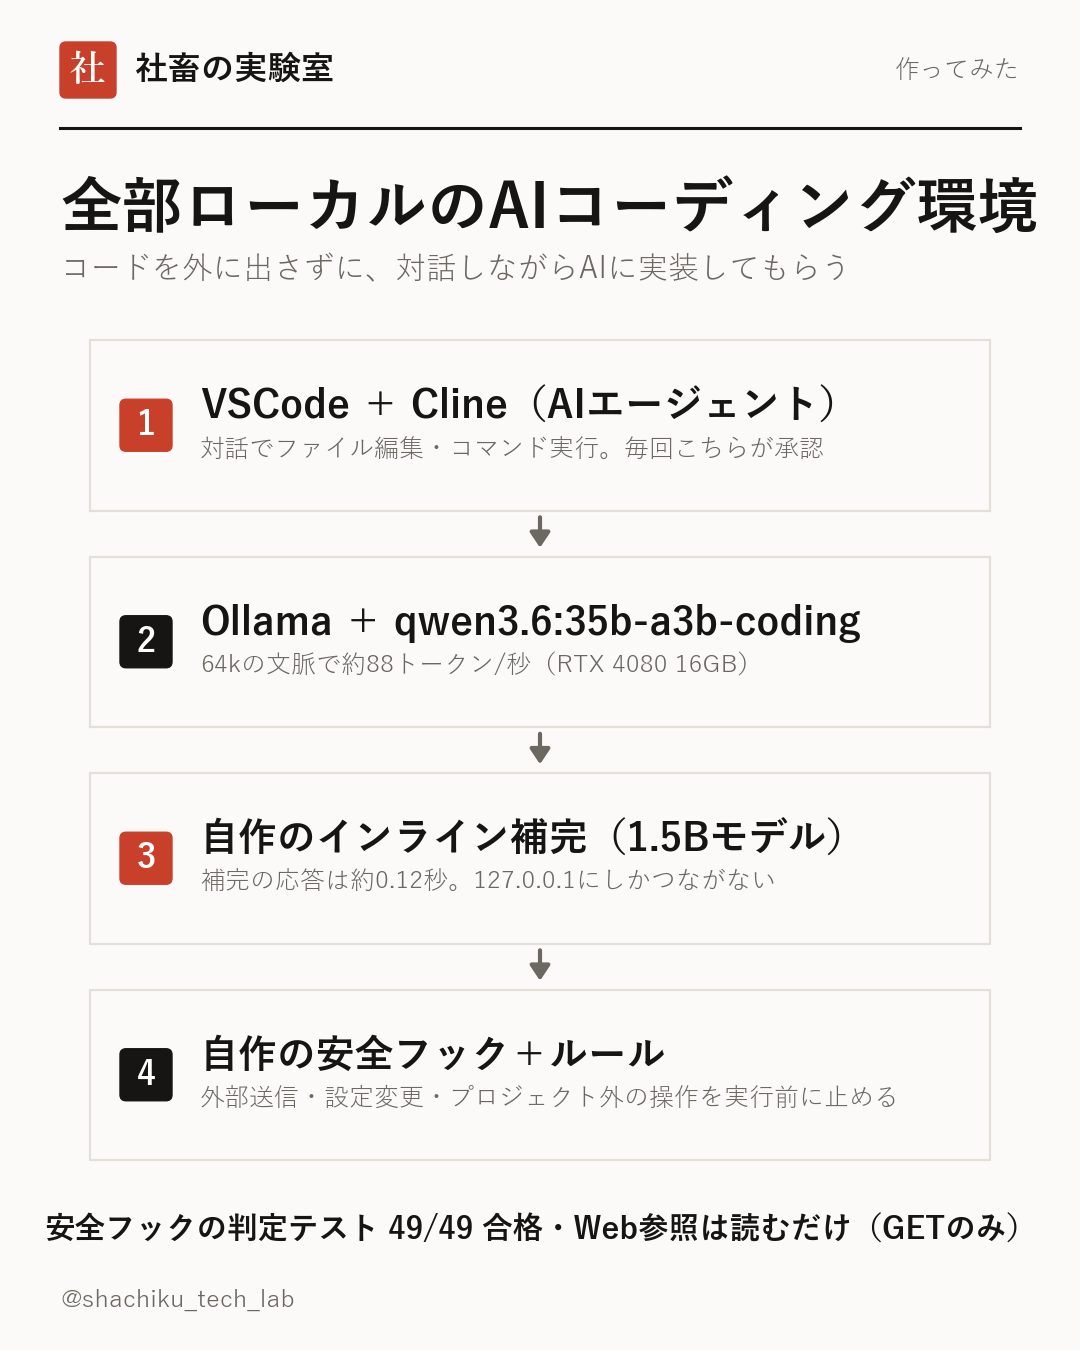
ローカルLLMでAIコーディング環境を作る|Cline+Ollamaで外部送信なし・実測88トークン/秒
VSCode の Cline と Ollama(qwen3.6:35b-a3b-coding)で、コードを外部に送らないAIコーディング環境を作った記録。RTX 4080 での実測速度、外部送信を防ぐ設定、AIエージェントを止める自作の安全フック、自作のインライン補完までまとめました。
Excel関数をAIに正確に聞き出すための3つのポイント
「AIに聞いても、思うような関数が返ってこない」と感じている方へ。情報の伝え方を工夫することで、AIを強力な業務の相棒にするための具体的な手順を解説します。
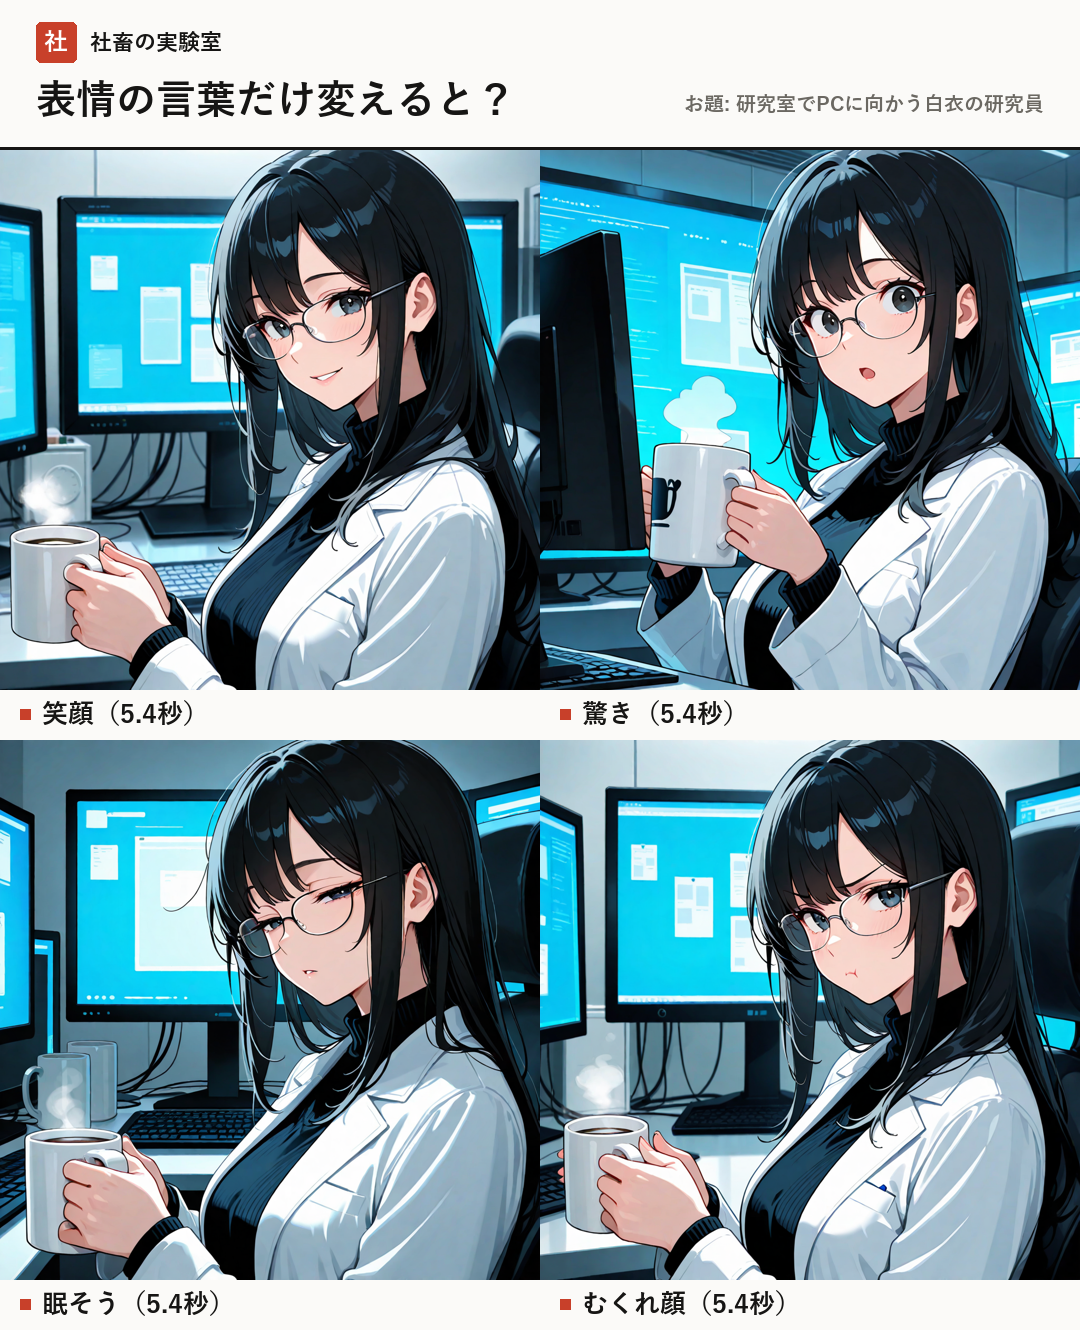
画像生成AIにおける表情の指示:単語ひとつで変化するキャラクターの印象
プロンプト(AIへの指示文)に加える「表情」に関する単語が、生成される画像の細部にどのような影響を与えるかを検証しました。
CPUのスレッド数を制限しても速度が変わらない?ローカルLLMのボトルネックの正体
自分のPCで生成AI(ローカルLLM)を動かす際、CPUのコア数やスレッド数が多ければ多いほど速くなると思われがちです。しかし、実験の結果、スレッド数を半分に絞っても速度にほとんど変化がないことが分かりました。なぜこのような現象が起きるのか、その理由を探ります。
ローカルAIを最も手軽に始めるための第一歩:Ollamaの活用法
自分のPC上でAIを動かす「ローカルAI」の世界へ入るための、最もシンプルな入り口であるOllamaについて解説します。
自分のPCでAIを動かす最大の利点は「安心感」と「自由度」
ローカルAIを導入する際の大きなメリットである機密情報の保護や、具体的な活用事例について解説します。
AIに長い資料を読み込ませる際の注意点:コンテキスト長とメモリの関係
ローカル環境でAIを動かす際に重要となる「コンテキスト長」の仕組みと、PCのメモリ消費との関係について解説します。
ローカルAIの選び方の基本:モデル名の「B」という数字の意味と速度の関係
ローカル環境でAIを動かそうとした際、最初に出会うのが「4B」や「9B」といったモデル名です。この記事では、これらの数字が何を意味するのか、そして自分のPCスペックに合わせてどのようにモデルを選べばよいのかを詳しく解説します。
ローカルAIを動かす鍵は「VRAM」の容量にあり!GPUメモリと速度の関係を解説
ローカル環境でAIを快適に動かしたいと考えている方にとって、最も重要なスペックの一つが「VRAM(ビデオメモリ)」です。なぜVRAMが重要なのか、実際にモデルを動かした際の劇的な速度差を交えて詳しく解説します。