VRAM 16GBの限界に挑む!文章AIと画像生成を共存させるための「メモリ譲り合い」の技術
「自分のPCでAIを動かしたいけれど、メモリが足りなくて画像を作ると文章の反応が遅くなる……」そんな悩みを持つ方へ。今回は、VRAM 16GBという限られたリソースの中で、いかに効率よく複数のAIを動かすかという実戦的な知見をお届けします。
- 【課題】RTX 4080(16GB)では、文章生成モデルと画像生成ソフトを同時に常駐させるのが難しい
- 【速度の変化】ツールを起動するだけで、文章の生成速度が「一瞬」から「少し待つ」レベルまで低下する実態
- 【解決策】画像生成時のみソフトを起動し、その瞬間に文章AIをメモリから外す「動的な入れ替え」
- 【高度な調整】バックグラウンド処理によるメモリの再占拠を防ぐための排他制御(順番待ち)の実装
- 【効率化】複数のキャラアイコンを作る際は、一括生成で待ち時間を最小限にするコツ
VRAM 16GBという「壁」の正体
自前のPCでAIを動かす際、最も重要なスペックの一つがVRAM(ビデオメモリ)です。これはグラフィックボードに搭載されているメモリのことで、AIモデルを動かすための「作業机」のような役割を果たします。
今回の実験では、比較的高性能なRTX 4080(16GB)を使用しましたが、ここで一つの壁にぶつかりました。文章生成用のモデル(gemma4:12b-it-q8_0)を読み込むと約13.1GBのメモリを消費します。これに対し、画像生成ソフトであるForgeもメモリを必要とするため、両方を同時に「載せたまま」にするのが難しいのです。
- 文章AI(gemma4:12b-it-q8_0)の消費量:約13.1GB
- 画像生成ソフト(Forge)との競合:同時に載せるとメモリが不足する
速度への影響:常駐させるだけで「快適さ」が変わる
AIを動かす際の体感速度は、VRAMの状況に大きく左右されます。実験の結果、画像生成ソフト(Forge)が起動しているだけで、文章AIの生成速度には大きな変化が見られました。
具体的には、何も起動していない状態では「一瞬」で出力されるレベル(62トークン/秒)だったものが、Forgeを起動するだけで半分以下の33トークン/秒まで低下しました。さらに、そこに文章生成モデルまで載せてしまうと、14〜18トークン/秒まで落ち込んでしまいます。
この数値は「少し待つが使える」という体感に近いものです。快適な速度を維持するためには、常駐させない工夫が必要だと分かりました。
- Forge未起動時:62トークン/秒(一瞬で出る)
- Forge起動時:33トークン/秒(読むより速く快適)
- モデルも同時展開時:14〜18トークン/秒(少し待つが使える)
このサイトの実測データ
解決策:「動的なメモリ管理」の実装
この問題を解決するために、このアカウントでは「必要な時だけ場所を譲り合う」という仕組みを導入しました。基本的には画像生成を行わない時はForgeを終了させ、画像が必要になった瞬間だけ起動させるという方式です。
しかし、これだけでは不十分でした。画像生成の直前に文章AIをVRAMから下ろしても、システムが裏側で行う「後処理」によって、下ろした直後にモデルを勝手に載せ直してしまう問題が発生したためです。
そこで導入したのが、処理の順番を制御する仕組みです。「画像生成中は後処理を止め、後処理の最中には画像生成を待たせる」という排他制御(複数の処理が重ならないように順番を決めること)を加えることで、VRAMの競合を回避することに成功しました。
- 手順1:画像生成の直前に文章AIをVRAMから解放する
- 手順2:画像生成中はバックグラウンドの後処理を一時停止する
- 手順3:後処理が終わるまで画像生成の開始を待機させる
さらに効率を上げるためのコツ
最後に、よりスムーズに作業を進めるための運用上の工夫を紹介します。例えば、複数のキャラクターのアイコンを一気に作りたい場合です。
一つずつ画像生成を行うと、そのたびにソフトの起動やメモリの入れ替えが発生し、待ち時間が積み重なってしまいます。これを防ぐために「全員分のプロンプト(AIへの指示文)を先にまとめて作成し、一回の画像生成プロセスでまとめて出力する」という方法をとっています。
この工夫だけで、待ち時間を最小限に抑えつつ、効率的に素材を揃えることが可能です。
- 複数のアイコンを作る際は、個別に生成しない
- 全員分のタグ(指示内容)を準備してから一括で生成する
- これにより、ソフトの起動・終了やメモリの入れ替え回数を最小限に抑える
まとめと次回予告
VRAM 16GBという環境では、すべてのAIを常に動かしておくのではなく、状況に応じて「メモリの席」を譲り合う仕組みを作ることで、文章生成と画像生成の両立が可能になります。
次回の第5回では、より高度な内容として「長い物語を覚えておく仕組み」と、目的に応じた「モデル選びの基準」について詳しく解説します。
- 次回テーマ:長い物語を覚えておく仕組み
- 次回テーマ:モデル選びの基準
読者への問いかけ
みなさんのPCでは、AIを動かす際にメモリ不足を感じることはありますか?もしあれば、どのような状況で困っているかぜひ教えてください。
- 自分のPCでAIを動かしたいけれど、スペック不足に悩んでいる人
- 文章生成と画像生成の両方を効率よく使い分けたい人
- ローカル環境でのAI運用の技術的な工夫を知りたい人
- 大企業向けの導入事例を探している人
- 特定の絵師の画風を模倣したい人
- ゲーム機の最新情報を知りたい人
よくある質問
Q. なぜRTX 4080(16GB)で両立が難しいのですか?
文章生成モデル(gemma4:12b-it-q8_0)だけで約13.1GBのVRAMを占有するため、画像生成ソフトやその他の処理のためのメモリ的な余裕がほとんど残らないためです。
Q. Forgeを起動するだけで速度が落ちる理由は?
Forgeというソフト自体がVRAMの一部を確保して動作するため、AIモデルに割り当てられるメモリや計算リソースが圧迫されることが原因です。
続きはThreadsで。新しいAIの実測と、仕事で使えた使い方を毎日投稿しています。
@shachiku_tech_lab をフォロー関連記事
【解説】AIだけでキャラのボイスと衣装を完全自作する仕組み
「AI麻雀道場」の第3回で公開した、AIを活用したキャラクター制作の裏側を詳しく解説します。自分のPC(ローカル環境)だけで完結させるためのポイントをまとめました。
画像から3DキャラをAIで作る|Hunyuan3D-2.1でVRChatアバターに挑戦した失敗と対策
画像生成AIで描いた設定画を Hunyuan3D-2.1 で3Dモデルにし、VRChat アバターを目指す挑戦の記録。横顔が崩れる理由、3D化AIのあるある失敗6つ、自動リギング(SkinTokens)の結果、次の作戦をまとめました。
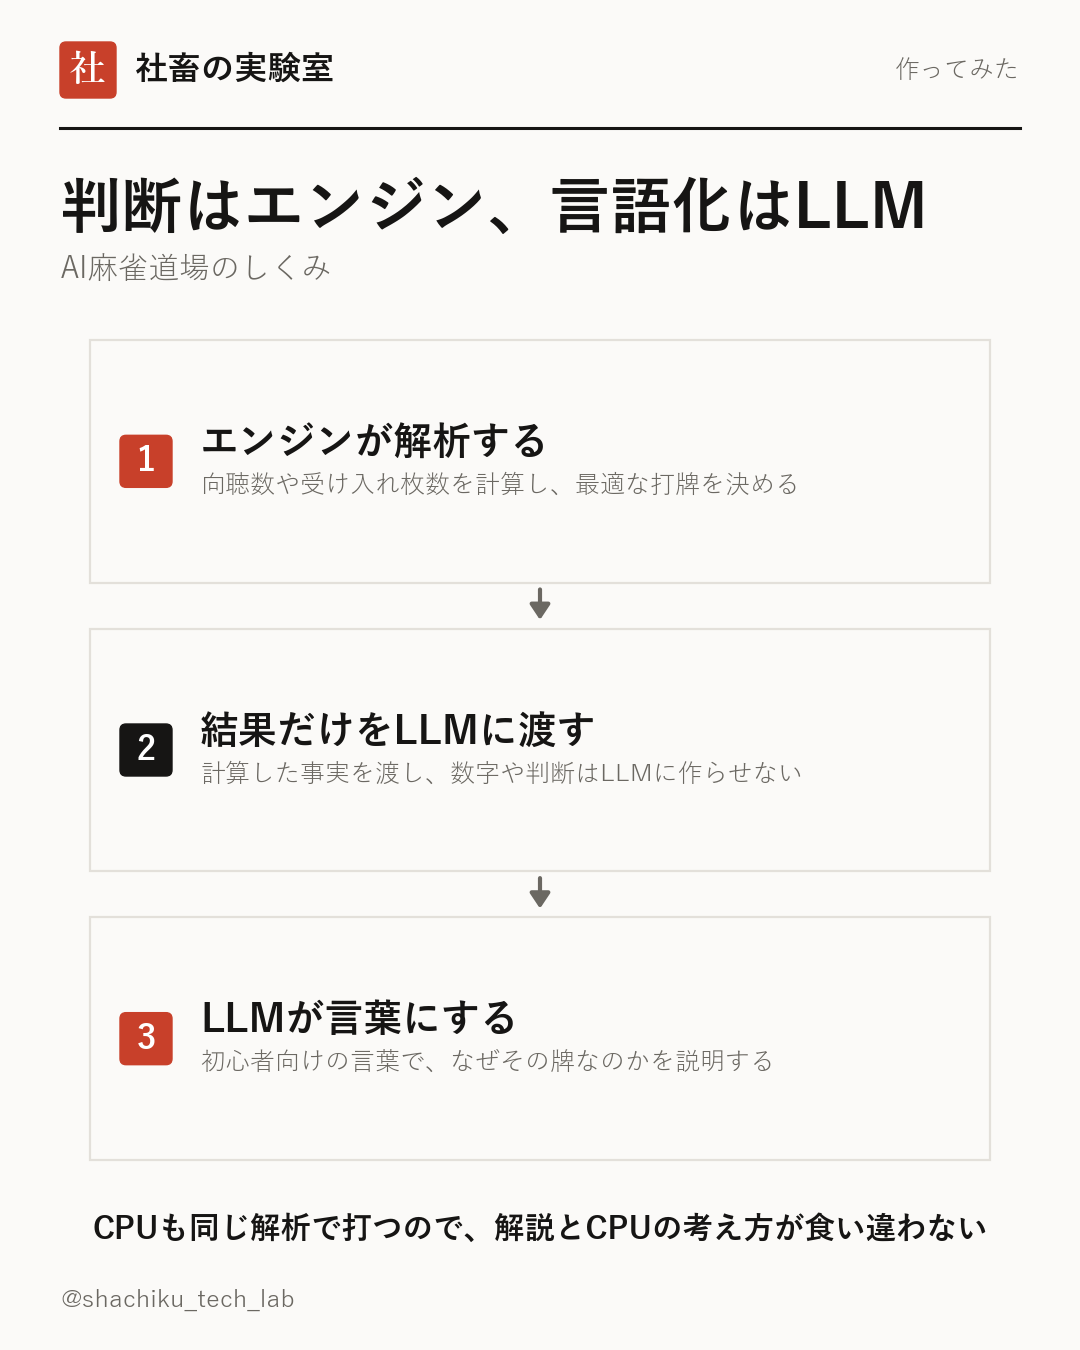
AI麻雀道場 第2回:判断はエンジン、言語化はLLM
ローカルAIを活用して麻雀を学ぶツール「AI麻雀道場」の開発秘話。なぜLLMにすべてを任せてはいけないのか、正確な解説を実現するための「役割分担」の仕組みについて詳しく解説します。
新しいモデルの実測や解説を毎日投稿しています
Threadsでフォロー以上、本日の業務日報でした。