【連載最終回】AIに長編物語を記憶させるコツと、失敗しないモデル選びの基準
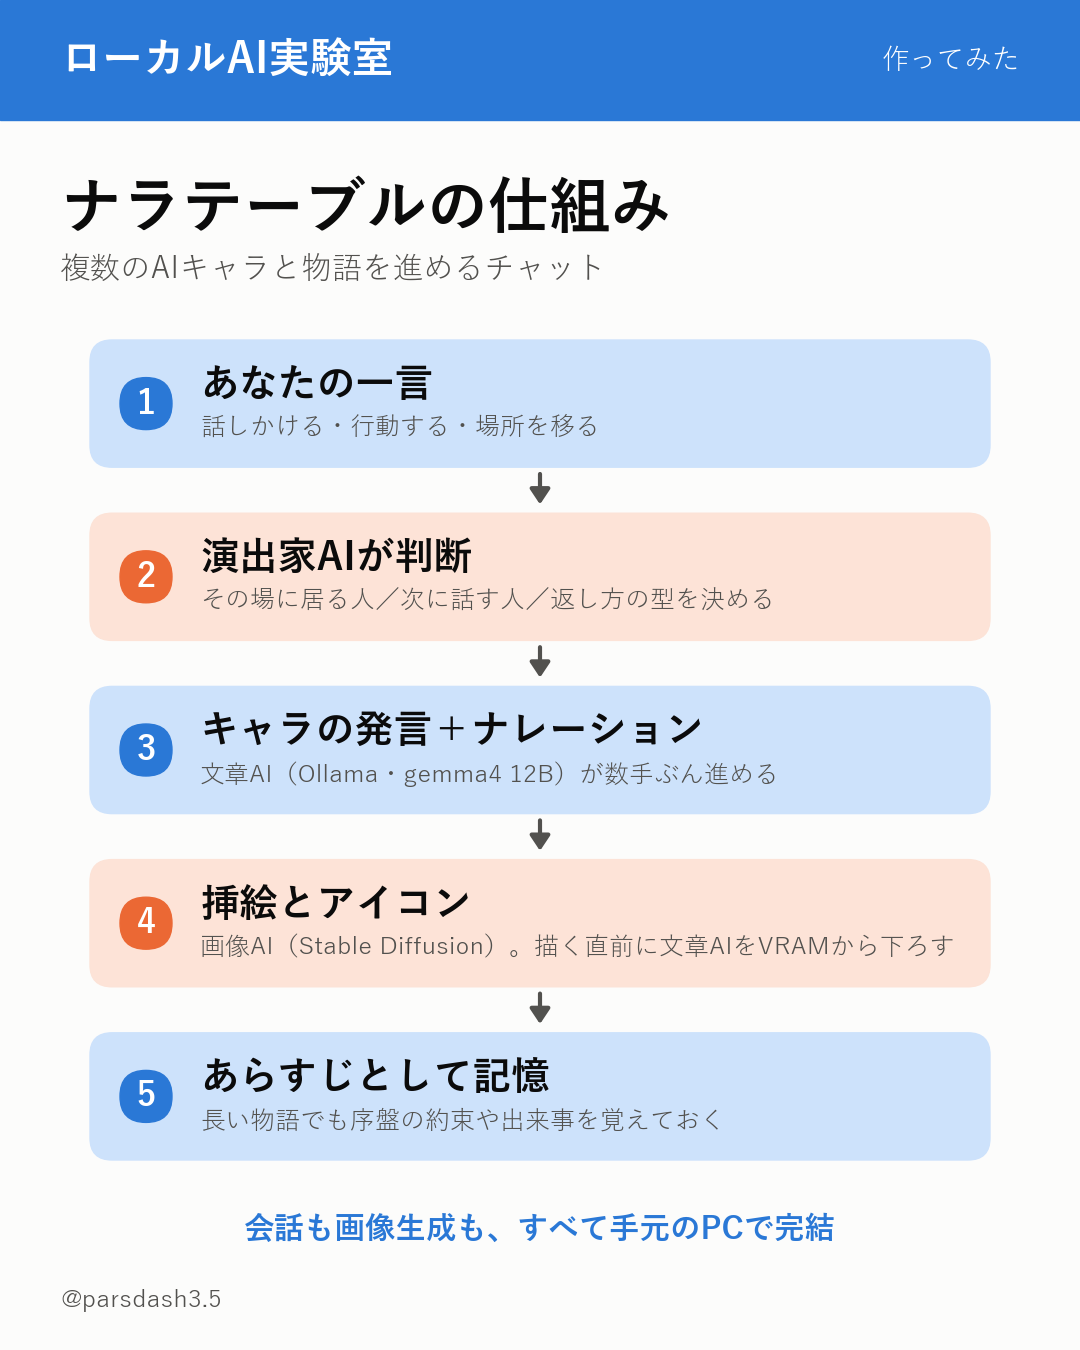
AIと長編の物語を紡ぐとき、最大の壁となるのが「記憶の限界」です。AIとの会話が長くなると、それまでの内容が記憶の枠(コンテキスト)から溢れてしまい、大切な設定や約束を忘れてしまうことがよくあります。 この問題を解決するために、今回開発した「ナラテーブル」では、会話が溜まる前に古い発言を自動で「あらすじ」へとまとめる仕組みを導入しました。これにより、誰が何をしたか、どのような約束をしたかといった重要な情報が残り続けるため、長編でも一貫性を保ったまま物語を進めることが可能になります。
- JSONスキーマによる出力の固定 システム内部では、AIの出力を「演出家・内心・好感度・返答候補」の4項目に固定するためのJSONスキーマ(データの構造を定義するルール)を使用しています。これにより、AIの反応を安定させ、物語の進行を正確に制御しています。
実測データから見るモデルの特性(RTX 4080環境)
実際に自分のPC環境で動かした際の数値をまとめました。モデルのサイズや圧縮の度合いによって、速度と品質のバランスが変わることがわかります。 ・gemma4:12b-it-q8_0 VRAM(ビデオメモリ:画像処理やAI計算に使う専用メモリ)使用量:13.13GB 速度:45トークン/秒(一瞬で反応するレベル) ・gemma4:12b(Q4_K_M) VRAM使用量:8.08GB 速度:64トークン/秒(非常に高速な反応) 数値としてはQ4の方が圧倒的に速いですが、実用面では注意が必要です。Q4モデルは速度に優れる反面、長い会話を続けると語尾がぶれやすくなる傾向が見られました。
- 速度の目安:30トークン/秒以上であれば、一瞬で文字が出てくる感覚です。
失敗しないためのモデル選びの基準
ここが非常に重要なポイントです。日本語のロールプレイ(物語のやり取り)に特化して調整されたモデルは、実は「構造化出力(あらかじめ決めた形式で正しく答えること)」が苦手な場合が多いです。 そのため、物語の表現力がどれだけ高くても、指示への追従性が低いモデルを選んでしまうと、システム自体が動かなくなるリスクがあります。今回の実験では、創作の巧さよりも「指示通りにデータを出力できるか」を優先してモデルを選定しています。
- 27B級モデルの注意点:Q4_K_Mで動かすと約15.5GiBになり、16GBのVRAMには収まりません。メモリが足りなくなると計算処理がCPUへと逃げるため、速度は数分の1まで低下してしまいます。
このサイトの実測データ
思考モードと速度の関係
さらに、AIの「思考モード」をONにする場合は注意が必要です。思考モードを有効にすると、AIは回答を出す前に長い推論(思考のプロセス)を行うため、体感速度は倍以上遅くなる傾向があります。用途に合わせて、速度と精度のバランスを調整することが大切です。
- 速度の目安:5トークン/秒を下回ると、待ち時間が気になり始める感覚です。
まとめ:実験を通して学んだこと
今回の「ナラテーブル」連載を通じて、AIに複雑な物語を扱わせるには、単に高性能なモデルを使うだけでなく、システム側での「記憶の整理」と「出力の固定」の両立が不可欠であると再確認できました。 自分のPCでAIを動かす際は、メモリ容量を意識しながら、モデルの「表現力」と「指示への正確さ」のバランスを検討してみてください。
- 皆さんは、AIを使って物語を書いたり、ロールプレイをしたりしたことはありますか?
- AIに長編の物語を動かしてみたい人
- 自分のPCのスペックとAIモデルの相性を知りたい人
- AIの記憶力の限界を解決する仕組みを知りたい人
- ゲーム機での動作方法
- 大企業のAI導入事例
- 株価や資金調達のニュース
よくある質問
Q. なぜ27Bモデルを16GBのVRAMで動かすと遅くなるのですか?
公式の情報では、27B級モデルをQ4_K_Mで動かすと約15.5GiBになるため、16GBのVRAMには収まりきりません。メモリが足りない場合、処理がCPUへ移行するため、速度が極端に低下します。
Q. モデルを乗り換えたら動かなくなったのはなぜですか?
日本語ロールプレイ向けモデルは、構造化出力(指示への正確な追従)が弱い場合があるためです。特定の出力形式を前提としたシステムの場合、その指示に従えないモデルに変えると動作しなくなることがあります。
続きはThreadsで。新しいAIの実測と、仕事で使えた使い方を毎日投稿しています。
@shachiku_tech_lab をフォロー関連記事
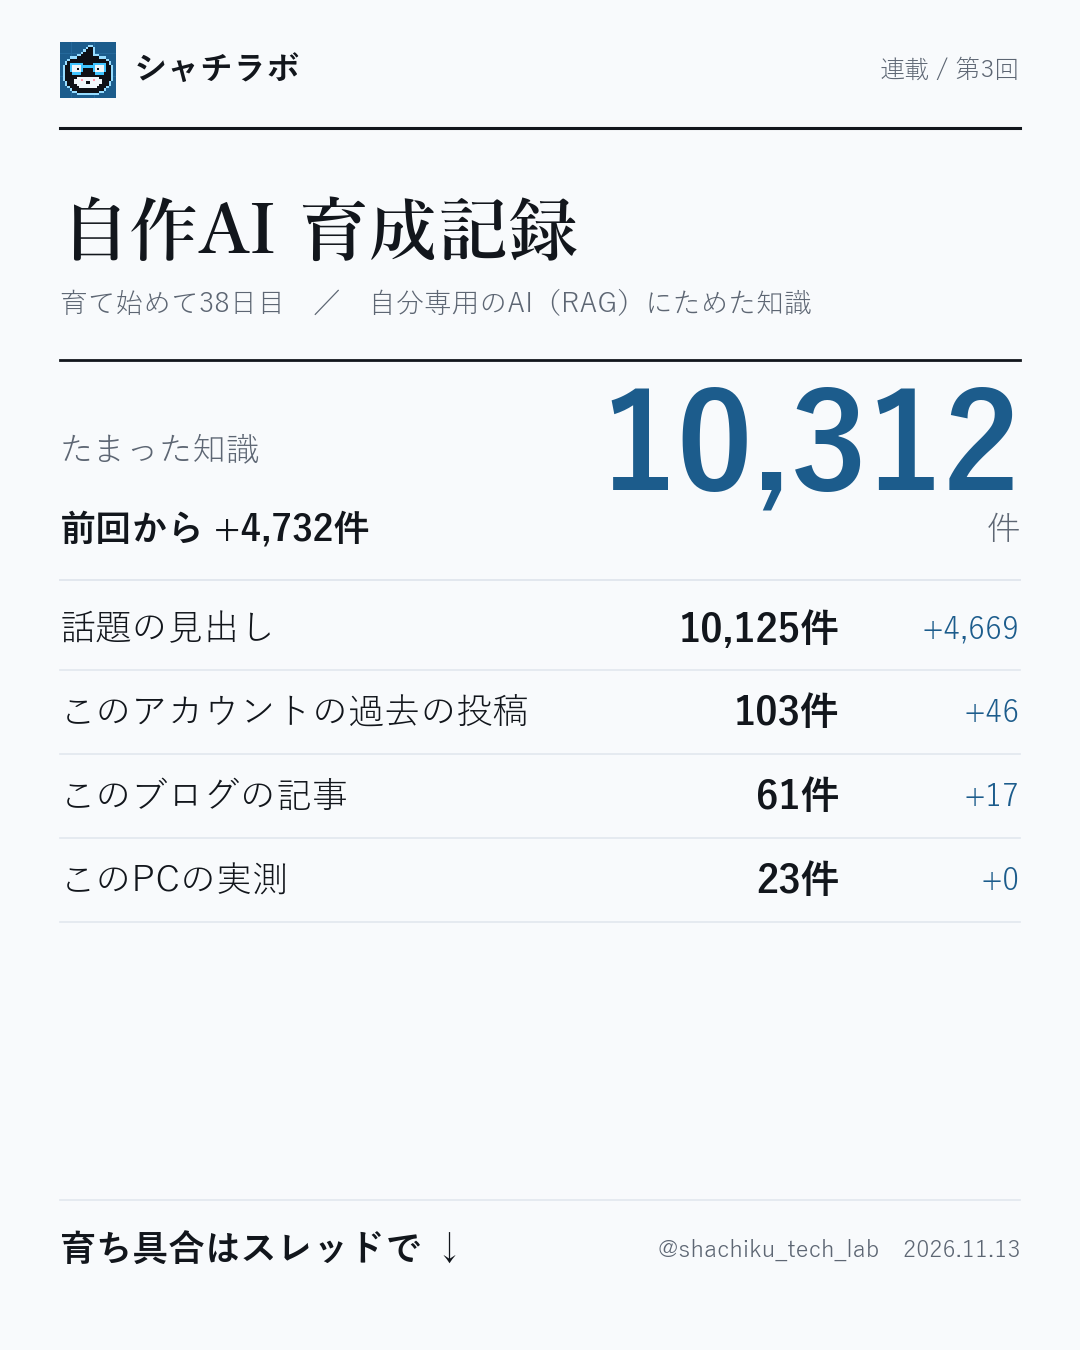
【自作AI育成日記 第3回】わずか38日で知識ベースが1万件を突破した過程と仕組み
自分専用のAIを育成する過程で、どのように知識を集め、どのように活用しているのかを詳しく解説します。
AIにメールの下書きを任せる際に「手直し」を減らすための5つのコツ
AIにメールの下書きを依頼する際、やりがちな「丁寧すぎて長すぎる」「意図と違う」といった問題を解決するための具体的な指示の出し方と、運用上の注意点を詳しく解説します。
画像が増えても重くならない!ギャラリー表示を劇的に高速化する最適化の技術
「画像が増えるほど動作が重くなる」という、Web制作やアプリ開発でよくある課題を、実際に「カベガミ工房」の最適化を通じて解決した事例を解説します。ブラウザのメモリ管理やデータ処理の効率化について、初心者の方にも分かりやすく紐解きます。
新しいモデルの実測や解説を毎日投稿しています
Threadsでフォロー以上、今日の実験ログでした。